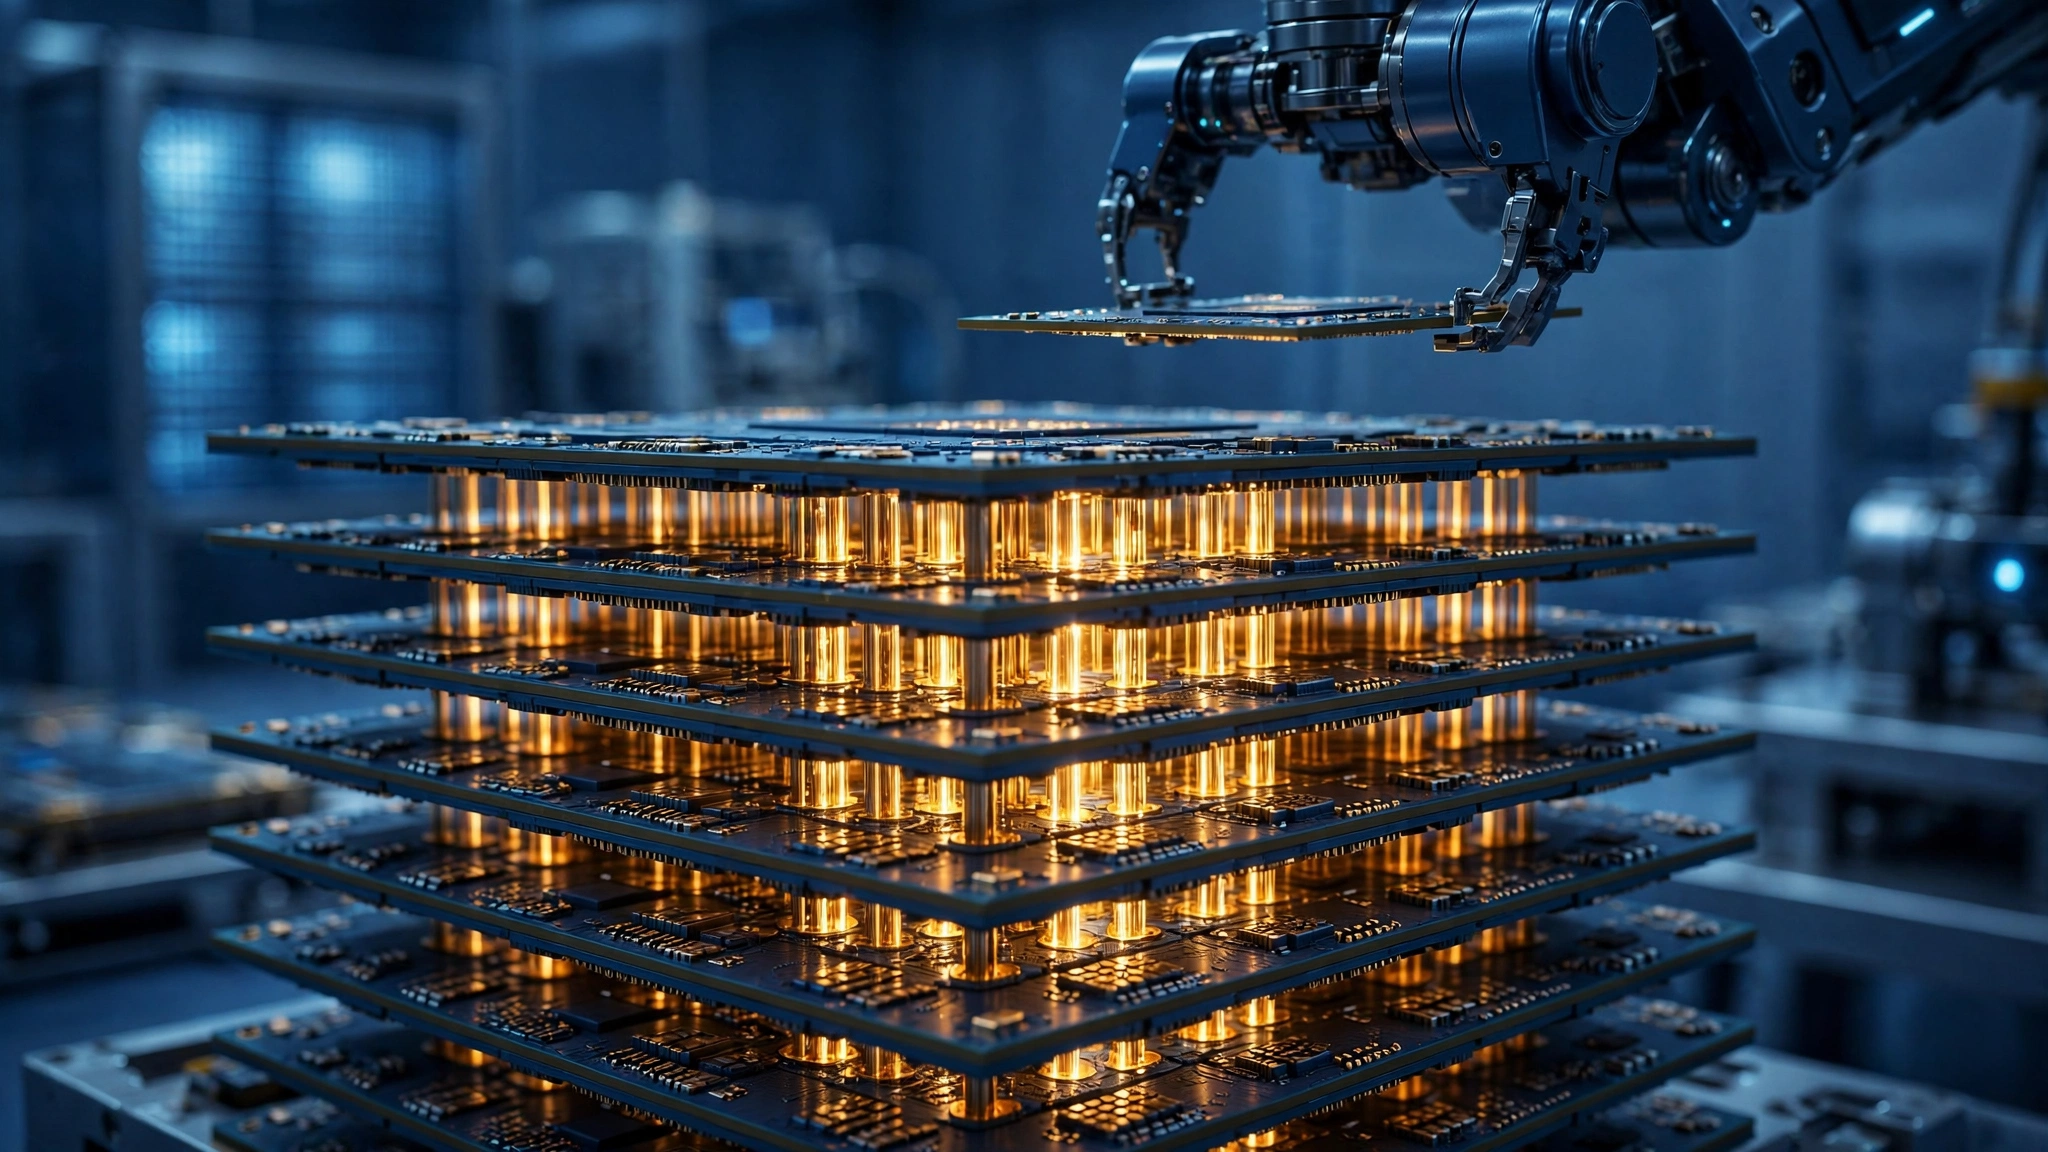
HBM(高带宽内存)和普通内存条里的 DRAM 不是一回事。它是把多颗 DRAM 裸片像千层饼一样垂直堆叠、用硅通孔(TSV)打通的"内存摩天楼",专为 AI 加速卡设计——GPU 做大模型推理时,最大的瓶颈从来不是算力不够,而是"喂数据"的速度跟不上。三星的 HBM4 单颗堆叠容量达 36GB、带宽冲到 3.3TB/s,几乎是 HBM3E 的三倍。
更关键的是商业模式:HBM 不走现货市场,全靠一年一签的长期合同,量和价都提前锁定。这意味着每年的谈判窗口,就是未来一年整个 AI 硬件成本的"定价锚"。谁在谈判桌上占上风,谁就拿走未来一年的利润。
谷歌 AI Overviews 诞生之初就带着原罪色彩:它把用户原本要去十个网站翻答案的问题,直接在搜索结果页顶部用 AI 生成一段总结回答掉。用户得到答案,满意地关掉页面;出版商则眼睁睁看着 referral 流量一路下滑,广告和订阅收入被拦腰斩断。
Chegg 的处境最有代表性。这家在线教育平台的商业模式几乎完全建立在「学生搜题 → 跳转 Chegg 看答案」之上。AI Overviews 上线后,大量习题答案直接出现在搜索页,Chegg 的流量和股价双双崩塌——它甚至不得不裁员、转向 AI 化自救。Penske Media 则代表传统出版阵营:内容被 AI 摘要引用,自己却拿不到一分钱,还要担心用户不再点进原文。
两家公司去年提起诉讼,核心指控是「捆绑胁迫」:谷歌迫使出版商允许其内容被 AI Overviews 摘要——否则就别想被 Google Search 收录。他们认为,在一个真正竞争的搜索市场里,谷歌应该为转载他们的内容付费,或者为训练 AI 支付许可费。
有意思的是,主审法官 Amit Mehta 正是 2024 年裁定谷歌构成非法搜索垄断的那位法官。这次,他却站在了谷歌一边。
Mehta 在裁决书中写道:原告主张的只是「一种期待——期待只要免费提供内容,谷歌就会给他们导流。但期待不是协议,这就是通用搜索引擎的运作方式。」("an expectation is not an agreement. It is simply how a general search engine works.")
他承认自己对出版商的处境「并非没有同情」(not unsympathetic)——谷歌确实拿走了别人的内容、转手变成自己的 AI 摘要,还不给补偿。但他同时划出一条清晰的司法边界:反垄断法不能代替立法者,去处理技术创新带来的经济伤害。 换句话说,这是一个真实存在的问题,但法院不是解决它的地方。
这不是 Mehta 第一次这么判。今年 3 月,他已经驳回过另一家出版商针对谷歌的类似指控。两起案件(Chegg Inc v. Google LLC,案号 25-cv-543;Penske Media Corp v. Google,案号 25-cv-3192)至此全部出局。
短期看,这份裁决给所有想效仿 Chegg 的出版商泼了一盆冷水:在美国法院,用反垄断法挑战 AI 摘要的路基本被堵死了。 接下来出版商大概率转向三条路:一是版权诉讼(主张 AI 摘要构成对原文的替代性使用);二是集体游说立法,复制澳大利亚《新闻媒体议价法》的模式;三是接受现实,与谷歌谈判拿「内容许可费」——谷歌的百家出版商试点,已经为这个剧本写好了开头。
1991 年,理论物理学家 Paul Ginsparg 在洛斯阿拉莫斯国家实验室搭起了一个简单的论文共享站点——arXiv。它允许研究者在论文正式发表、同行评审之前,先把成果公开挂出来。三十多年后,它成了全球科学家的"学术朋友圈":物理、数学、计算机科学、定量生物学……每天都有成千上万篇新论文在这里首发。
第一,AI 编程代理的竞争从「模型能力」转向了「可塑性」。 当各家模型在编码基准上咬得越来越紧,开发者真正分化的战场变成了:这个工具能不能长成「我想要的样子」。Mods 让团队可以把内部规范(比如「所有数据库迁移必须先过审批面板」)写成 Mod 分发给全员,而不是靠口头约定和复制粘贴的提示词。智能体从「通用工具」变成了「可定制的平台」。
第二,「无沙盒」是一把双刃剑,Anthropic 把选择权交给了用户。 官方文档明确警告:Mod 以 Claude Code 本体的全部权限运行——能读文件、起进程、联网。装了一个恶意 Mod,就等于把整台机器交了出去。Anthropic 给出的建议很直白:只从可信来源安装,安装前先读代码,还提供了 claude plugin validate 命令预先列出 Mod 监听了哪些事件、会做什么。这是一种「成年人式」的开放:不替你做安全决策,但把审计工具给你。
这轮 AI 基建竞赛,最先「吃香」的是 GPU 和高带宽内存,但成本压力很快沿着数据链条向后传导。一个大模型的训练数据、推理日志、备份与冷数据,不可能全泡在昂贵的闪存里——HDD 单位容量的成本优势在海量、长期保存的场景下依然无人能替。生成式 AI 越火,产生的「数据债务」越重,数据中心需要的不只是更强的算力,还有更便宜的「仓库」。
有意思的是对手的态度:希捷和西数两家对新建工厂意兴阑珊,更倾向于优化现有产线效率。这恰恰给东芝留出了一条缝隙——当双寡头选择「躺平收租」,第三名反而敢下重注。600 亿日元在 AI 基建的投资尺度里不算大钱,但对一个五年没动过大规模资本开支的部门来说,这是一次方向性的押注:赌的是「AI 数据中心对大容量存储的需求是结构性的,而非周期性的」。