$tail -f ./life.log

瞬间

碎片化的图文动态,记录此刻。

「Kafka 头号"刺客"现身」:Cloudflare K2 开放公测,Serverless 事件流杀入数据基建腹地
背景:被 Kafka 统治的十年,与 Serverless 的缺席

事件流是现代数据架构的神经系统:电商下一单,要同时触发风控、数据分析、消息通知;IoT 设备每秒上报遥测;AI 智能体的每一步动作都要被记录、回放、审计。过去十年,这个位置几乎被 Apache Kafka 垄断。

Kafka 强,但运维重:分区、副本、ISR、rebalance,一套生产级集群养下来需要专职团队伺候;云托管(MSK、Confluent Cloud)又贵得让中小团队肉疼。Serverless 化了计算(Lambda、Workers)、数据库(Neon、PlanetScale)、对象存储(R2),唯独"事件流"这块高地,始终没有真正的 Serverless 原生玩家——直到昨天。

事件:K2 公测,Cloudflare 把日志建在了对象存储上

10 月 1 日,Cloudflare 官宣 K2 进入 public beta。这是 Cloudflare 开发者平台上的一个 durable event streaming primitive:你往 K2 stream 里写事件,它存成一条有序日志;消费者可以分片并行读(read parallelism),也可以每个消费者全量订阅(pub/sub 模式),两种模式还能混搭。

技术上最有意思的一点:K2 并没有自己造一套分布式存储,而是把"分区 durable log"直接建在了自家 R2 对象存储之上。对象存储有 11 个 9 的持久性和强一致 API,把复制和共识甩给存储层,应用层(K2)就可以做得极简、便宜、高性能,还天然存算分离、各自独立扩容。对象存储不支持 append(日志的标准操作),Cloudflare 的解法是:先在边缘服务内存里攒一批,攒够一个 segment file 一次性写入,再用 R2 的原子操作实现有序且严格递增的 offset,不需要额外的协调服务。

代价是写入延迟:对象存储写入比本地磁盘慢,还要等本地 batch 攒满,首版 K2 的 produce 延迟 p99 约 1 秒。Cloudflare 自己承认这是 trade-off,并预告了后续的 Express tier 来压低延迟。

计费方面,公测期免费,正式计费后预计:写入 0.04 美元/GB,读取 0.04 美元/GB,留存 0.02 美元/GB/月。公测限制:单账号最多 10GB 存储、每条 stream 30MB/s 写入。

定位上,Cloudflare 明确区分了自家三件套:Queues 面向"单个耗时任务"的异步执行(重试、延迟、死信队列);K2 面向高吞吐数据搬运、长期留存和扇出消费,消息按 batch 处理;Basin Pipelines 则是 serverless ingestion 服务,终点是写 R2 或 Iceberg 表。K2 最初就是为 Basin Pipelines 造的 ingestion 缓冲层——Cloudflare 自己的边缘跑不了 Kafka(335+ 城市、机器切片小且易失、跨公网传输),只好重新发明轮子。

路线图已经画好:multi-GB/s 级写入并行度、message key 与 key 级有序保证、push 式 Worker 消费者、Express 低延迟 tier,以及——对 Apache Kafka 客户端的 drop-in 兼容。Hacker News 上这条官宣拿下 130+ 点、近 50 条评论,开发者社区反响热烈。
分析:Serverless 化的最后一块拼图,为什么是现在

第一,对象存储造日志,是"存算分离"思潮的又一次胜利。WarpcStream 等新贵已经证明了这条路走得通;Cloudflare 的版本更进一步,直接复用 R2 的 11 个 9,连 ZooKeeper/KRaft 那套协调都省了。架构越简单,故障域越小。

第二,定价模型在"偷袭"Confluent。0.04 美元/GB 的读写加 0.02 美元/GB/月的留存,配合 Cloudflare 招牌的零 egress 费,对日志这种"写一次、读 N 次、存很久"的工作负载极其友好。长期留存(long-term retention)正是 K2 主打的差异点:消费者宕机几周,数据不丢,回来接着读。

第三,Kafka 客户端兼容是阳谋。一旦 drop-in 支持落地,存量 Kafka 工作负载可以零改代码迁移——这是当年 S3 兼容接口(R2、MinIO)用过的老剧本,屡试不爽。

第四,与 Basin GA 打配合。同一天,Cloudflare 还宣布数据平台 Basin 正式 GA(Pipelines、Catalog、SQL 三件套),Anomaly(开源 AI 编程智能体 OpenCode 背后的公司)已经把整条数据管线从 AWS S3+Athena 搬了过去。K2(流)+ Basin(存/查)= 一套完整的 serverless 数据栈,Cloudflare 的开发者平台拼图正在闭环。

风险也有:1 秒的 p99 写入延迟,实时风控、交易撮合这类场景现阶段不用考虑;公测 10GB/30MB/s 的上限说明 multi-GB/s 还在路上;以及 Serverless 的老问题——用量计费在大规模下可能反超自建,精打细算的团队得自己算账。
展望:事件流正在变成"水电煤"

K2 的象征意义大于产品本身:计算、存储、数据库之后,"流"这块最后的硬骨头也被 serverless 化了。未来三到五年,事件流很可能像对象存储一样变成按量付费的水电煤——你不再需要为"可能到来的峰值"提前买好 Kafka 集群。

对开发者的直接启示:如果你正在用 Cloudflare Workers 构建应用,K2 是第一款"边缘原生"的事件流,不用再为了一条日志管线去维护一套 Kafka;如果你在选型,Kafka 客户端兼容落地之日,就是可以认真做 PoC 对比之时。

一句话:Kafka 不会被 K2 一夜取代,但"运维 Kafka"这件事,正在从必修课变成选修课。

评论

…
「刚宣布拥抱 MCP,就被 Figma 关在门外」:AI 编程代理 Pi 的「开门红」只持续了三天

题图:AI 助手站在紧闭的数据大门前
题图:AI 助手站在紧闭的数据大门前

背景:Pi 的「真香」时刻

前几天我们刚报道过一出开源圈的"反转大戏":Earendil 的开源 AI 编程代理 Pi 宣布原生支持 MCP,官方博客标题就叫《You Said No MCP!》——要知道,Pi 的官网曾经白纸黑字声明不支持 MCP,创始团队还在播客里多次公开唱衰。如今把它请进内核,靠的是一套叫 Codemode 的核心解法:用 harness 信任层里的 JS 沙箱来编排 MCP 工具调用,解决了 MCP「难组合」的槽点。这条消息在 Hacker News 上拿下 613 点、341 条评论,开发者是真心欢迎这个转向。

但好日子没过几天,Pi 就撞上了一堵墙——而且是整个 AI 编程赛道里最重要的一堵墙之一:Figma。

事件:Figma 的 MCP 白名单

配图:数据流在检查站闸门前被过滤
配图:数据流在检查站闸门前被过滤

10 月 2 日,Hacker News 首页的一则讨论把这件事摆上了台面:Figma 把自家的 MCP 服务器锁在了白名单后面,而 Pi,不在名单上。

这不是传言,是 Figma 官方开发者文档里白纸黑字写着的规则:"Only clients listed in the Figma MCP Catalog are able to connect to the Figma MCP Server."(只有列在 Figma MCP 目录中的客户端,才能连接 Figma MCP 服务器。)想接入的新客户端?可以——"join the waitlist",排队去。

我们数了一下这个目录:Claude、Claude Code、ChatGPT、OpenAI Codex、Cursor、VS Code、Xcode(beta)、Kiro、Grok、GitHub Copilot CLI、Notion、Slack、Devin、Replit、Warp、Factory,再加上 Google Antigravity(但只允许本地连接、只读权限)。一共 17 个,清一色是商业大厂产品或已被大厂收编的工具。开源的 Pi,不在其中。

更微妙的是执行机制。Figma 的 MCP 服务器采用 OAuth 动态客户端注册(DCR),按 client_name 精确匹配放行。社区开发者实测发现:用自己的名字 "Hermes Agent" 去注册,直接 403 被拒;把名字改成 "Claude Code" 或 "Codex",立刻通过。这扇门认的不是「协议合规」,是「名字」。

再加上 Figma 的席位计费墙:View / Collab 席位在 Organization / Enterprise 计划下,每月只有 6 次 MCP 工具调用——AI 读一两次设计稿额度就没了;只有 Dev / Full 付费席位才能拿到每天 200–600 次的额度。门票、座位、名字,三重关卡。

社区的「野路子」

门关上了,但开发者社区从来不缺翻墙的梯子。GitHub 上已经流传开几套成熟方案:

第一招,冒名注册。按 OpenCode 社区文档的教程,用 Figma 的个人访问令牌(PAT)调用 OAuth 注册接口,把 client_name 填成白名单里的 "Claude Code (figma)",一次注册,PAT 就可以扔掉。

第二招,走 stdio 绕行。开源项目 figma-developer-mcp 通过本地 stdio 传输直接对接 Figma API,文档里明说 "works without whitelist restriction",连免费计划都能用。

第三招,桌面版 MCP。Figma 桌面应用的 Dev Mode 里可以打开本地 MCP 服务器(localhost:3845),不走远程鉴权这套体系,只是要求先在 Figma 里手动选中图层。

这些方案能用,但都有代价:冒名注册游走在服务条款的灰色地带;stdio 和桌面版方案功能受限。对 Pi 这样的开源项目来说,「能用」和「被官方支持」是两回事——后者意味着稳定性、文档,以及不会在某天早上突然失效的承诺。

分析:开放协议,封闭守门人

配图:设计稿与代码之间的光桥
配图:设计稿与代码之间的光桥

这件事最值得玩味的,是它戳破了 MCP 生态的一个美好幻象。

MCP 诞生时的口号是「AI 时代的 USB-C」:一个开放标准,任何模型、任何工具都能即插即用。但 Figma 的做法揭示了一个现实:协议可以是开放的,服务器可以是私有的。当最有价值的数据(设计稿、组件库、设计系统)掌握在平台手里时,「开放」就变成了「有条件开放」——条件由平台定。

Figma 的算盘不难理解:MCP 调用要消耗 API 资源,设计稿是核心资产,放开给所有客户端意味着成本失控和质量风险;白名单既是成本控制,也是商业谈判筹码。不止 Figma 一家这么干——ClickUp 的 MCP 服务器同样维护着一套客户端审查机制,新客户端必须提交审核才能走通 OAuth。这正在成为 SaaS 大厂的标配动作。

但对 Pi 来说,这个时间点格外残酷。它刚用 Codemode 解决了 MCP「难组合」的技术难题,转身就发现最大的设计数据源不让它进门。AI 编程代理的核心场景之一就是「设计稿转代码」——而 Figma 恰恰是这个场景的入口。更有意思的对比是:同样在目录里的 Factory——前几天刚和 Cognition 闹出董事会「间谍门」的 AI 编程公司——却拿到了 Figma 的入场券。开源的 Pi 被挡在门外,商业的 Factory 畅通无阻。这个对比本身,就很说明问题。

展望:MCP 生态的「双层化」

接下来可能发生什么?

短期看,MCP 生态会走向「双层化」:一层是官方白名单通道,稳定、合规、功能全,但只对「自己人」开放;另一层是社区野路子,灵活、免费,但永远在和平台的规则打游击。开发者会用脚投票,但企业客户大概率会选第一层——这正是 Figma 想要的结果。

中期看,Pi 们的选择不多:要么排队等白名单,把命运交给 Figma 的审核队列;要么像 OpenCode 社区那样把「冒名」做成一键脚本,把灰色地带常态化;要么干脆绕开 Figma 官方服务器、自建基于 PAT 的直连方案。无论哪条路,开源项目在与平台的博弈中都处于下风——这不是技术问题,是权力结构问题。

长期看,真正的考验留给 MCP 标准本身。如果越来越多的数据平台都学 Figma 立起白名单,MCP 的「开放」承诺就会被掏空成一句营销话术。是继续相信「协议中立」,还是承认「谁的数据谁做主」?这个问题的答案,将决定未来三年 AI 智能体生态是走向互联互通,还是走向一个个精致的围墙花园。

Pi 的「开门红」只持续了三天。但这三天里发生的事,可能是 MCP 生态在 2026 年最重要的注脚:技术可以反转立场,但商业的墙,反转不了。

评论

…

「偷拍眼镜」禁令被一票否决:加州州长叫停智能眼镜监管第一法,隐私保卫战才刚刚开始

加州智能眼镜法案被否决-题图
加州智能眼镜法案被否决-题图

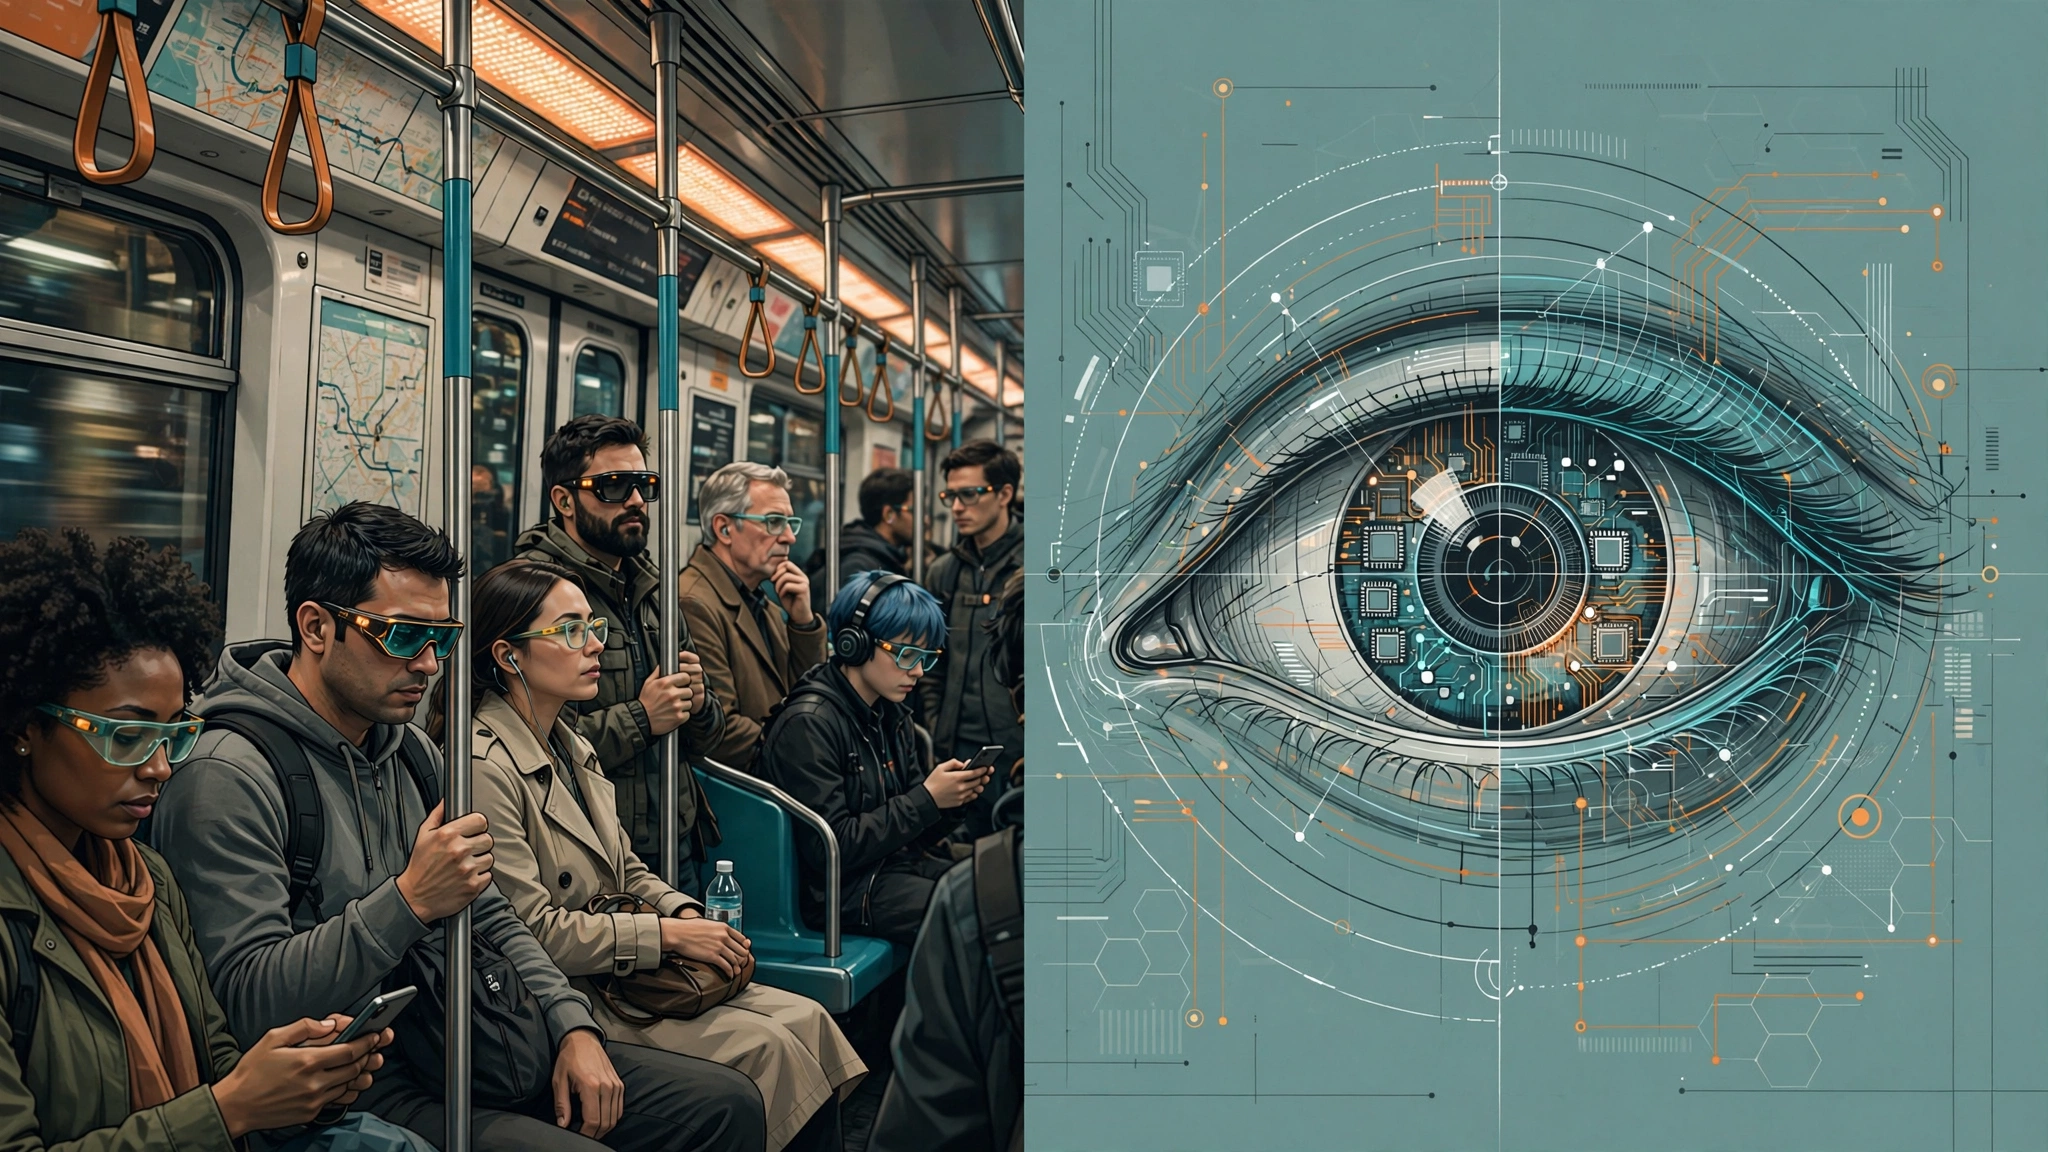
走在旧金山街头,你可能已经分不清对面那个人戴的是一副普通眼镜,还是一台正在录像的计算机。2026 年 9 月 30 日,美国加州州长纽森用一支笔,把全美第一部专门针对智能眼镜的法案拦在了生效门外。这场「监管」与「创新」之间的较量,短暂落幕,但真正的博弈才刚刚开始。

背景:700 万副眼镜,和看不见的镜头

智能眼镜正以前所未有的速度普及。Meta 的 Ray-Ban 智能眼镜自 2021 年推出后一路热销,去年一年就卖出了超过 700 万副;Snap、各类 AI 吊坠等「常听常拍」的可穿戴设备也纷纷入场。眼镜上那颗小小的摄像头和麦克风,理论上随时可以把周围的画面和声音传上云端、喂给 AI 模型分析。

公众的焦虑已经具象化为一个不太体面的称呼:有人把这些设备叫做「pervert glasses」(变态眼镜)。欧美社交媒体上,关于被智能眼镜偷拍、被跟踪的讨论越来越多。挪威甚至在考虑对这类技术实施更严厉的限制。当技术跑得比法律快时,人们总是寄希望于立法先堵住漏洞。

事件:SB 1130 法案,一次「未遂」的监管

这部被否决的法案,编号 SB 1130,由加州州参议员 Eloise Gómez Reyes 起草。它想做的事情很具体:

第一,把「用可穿戴设备在更衣室、诊室等私密空间偷拍」明确写进违法行为; 第二,从 2028 年起,要求智能眼镜等设备在录像、录音时必须亮起指示灯,让旁人能看出来; 第三,直接禁止销售任何「帮你遮住录制指示灯」的技术。

罚则也不含糊:个人违规最高面临 1500 美元罚款或监禁,设备厂商不合规最高罚 2500 美元。如果通过,加州将成为全美第一个单独对智能眼镜使用立法的州——此前的隐私法更多是针对手机、固定摄像头时代制定的。

但纽森在 9 月 30 日给出的否决理由,干脆利落地釜底抽薪:法案对「可穿戴录制设备」的定义太宽泛、太模糊,执行起来会造成混乱和意想不到的后果;而且加州法律里已经有现成的保护条款——加州本就是全美十几个要求「双方同意才能录音录像」的州之一,新法案在很多地方属于重复立法。

加州智能眼镜法案被否决-镜腿特写
加州智能眼镜法案被否决-镜腿特写

分析:否决的不是「隐私问题」,而是「立法手艺」

读懂这次否决,关键在于区分「方向」和「方法」。

方向上,几乎没人否认问题真实存在。一副和普通眼镜长得一模一样、却能静默录制 4K 视频的设备,确实击穿了我们对「被观察」的心理预期。传统上,我们判断自己是否在被记录,靠的是「对方举起手机」这个动作信号;智能眼镜把这个动作信号彻底抹掉了。更何况 AI 吊坠、Apple Watch 传闻中的常听转录功能,正在把「持续记录」变成穿戴设备的默认姿态。

但方法上,SB 1130 确实留下了把柄。「可穿戴录制设备」定义过宽,可能会误伤普通蓝牙耳机、运动手环这类本无争议的产品;强制指示灯听起来美好,但稍懂电路的人都知道,一颗贴纸或一滴黑胶就能让指示灯「失效」,法案反而还要再禁「遮蔽技术」——这是典型的「道高一尺、魔高一丈」式立法困境,执法成本和实际效果严重不成比例。纽森作为长期自诩「科技州」州长,不愿在法案措辞粗糙的情况下开这个先例,逻辑上并不意外。

值得注意的是,Reyes 在接受 ABC News 采访时说:「凡是能保护个人隐私的事,我们都必须做。」这句话透露了立法者的真实意图:先抢占「第一个吃螃蟹」的政治姿态,再慢慢打磨条款。否决反而给了她一个重新起草、做得更精细的机会。

展望:法案会回来,方式会变,行业跑不掉

加州智能眼镜法案被否决-隐私展望
加州智能眼镜法案被否决-隐私展望

接下来会发生什么?几条线索值得盯:

一是「2.0 版本」几乎必然出现。Reyes 完全可以把定义收窄到「具有图像/音频采集能力且外观与常规配饰无异的设备」,并把指示灯要求从硬件强制改成「产品认证」式的软性约束。加州议会已经通过了 SB 947 这样的 AI 雇佣法案,对科技立法的胃口不会因为一次否决就消失。

二是欧洲可能先行。挪威已经在研究限制方案,欧盟在《人工智能法案》之后,对「生物识别+可穿戴」组合的态度一贯强硬。如果欧洲先立规,加州反而会成为跟进者。

三是行业自律的窗口期正在收窄。Meta 们当然松了一口气,但「pervert glasses」这个词一旦在公众舆论里扎根,厂商们就得认真回答一个问题:你们的录制指示灯,是真的为了提醒旁人,还是仅仅为了应付公关?下一款智能眼镜如果还是把指示灯做成一颗几乎看不见的微光,舆论的反噬只会更猛。

对中国的智能硬件厂商来说,这也是一个前瞻信号:出海的可穿戴产品,隐私合规设计(指示灯、本地处理、明确的用户告知)迟早会从「加分项」变成「准入门槛」。与其等法案砸下来,不如把合规做在前面。

纽森这一票否决,否掉的是一部措辞粗糙的法案,而不是人们对隐私的焦虑。智能眼镜的镜头已经戴在了数百万人的脸上,法律的追赶才刚刚起步——这场关于「谁有权记录现实」的争论,远没有结束。

评论

…

「打印」出来的眼睛:开源桌面机器人 JBR-001 登上 HN 首页,物理 AI 迎来「树莓派时刻」

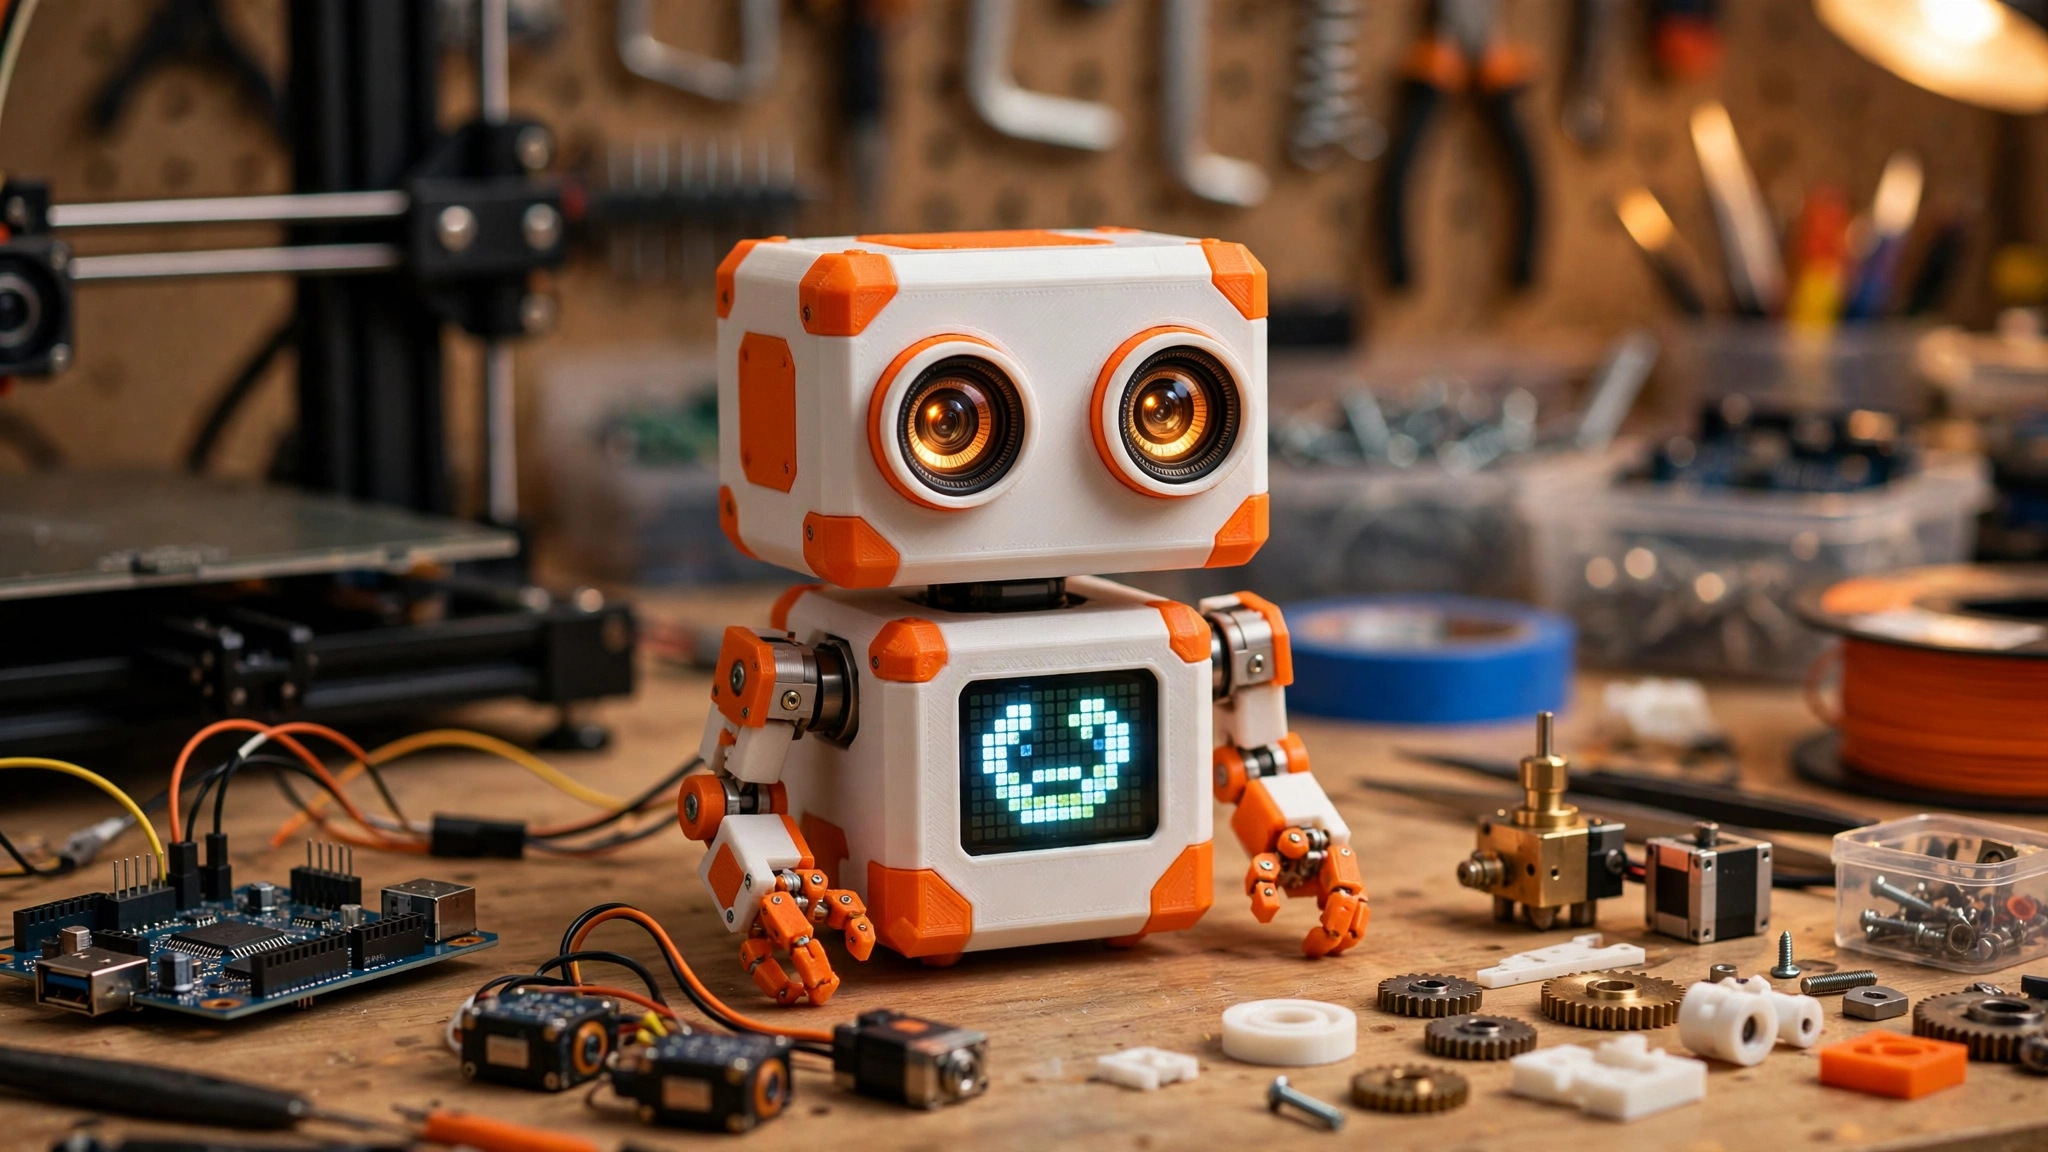
JBR-001 开源桌面伴侣机器人
JBR-001 开源桌面伴侣机器人

上周,一台造价不足百美元的小机器人登上了 Hacker News 首页。它不会扫地、不会端茶,甚至头号热评还在调侃它「腿是装饰品」。但这台叫 JBR-001 的开源桌面机器人,却被评论区公认为一件值得严肃讨论的事——因为它可能是物理 AI 的「树莓派时刻」。

背景:人形机器人风口下,被忽略的「平价实验层」

过去一年,「Physical AI」(物理 AI)几乎成了科技圈最拥挤的赛道:特斯拉 Optimus、Figure 的人形机器人、小鹏的 IRON、英伟达 Jim Fan 到处布道「机器人学的终局」,资本和巨头都在押注通用机器人的未来。但风口的另一面是门槛:动辄数十万的硬件成本、注塑模具、复杂的运动控制,让绝大多数开发者只能隔着屏幕看热闹。

与此同时,一条低调但持续的暗线正在生长:3D 打印机 + 开源硬件 + 边缘 AI。树莓派当年用 35 美元把通用计算送进了每个人的抽屉,而今天,一台桌面级 3D 打印机、几十美元的开源主板和逐渐白菜价的 AI 算力,正在把「造机器人」这件事变成周末爱好。JBR-001 正好踩在了这条暗线的正中央。

事件:一台能「看见你」的桌面小机器人

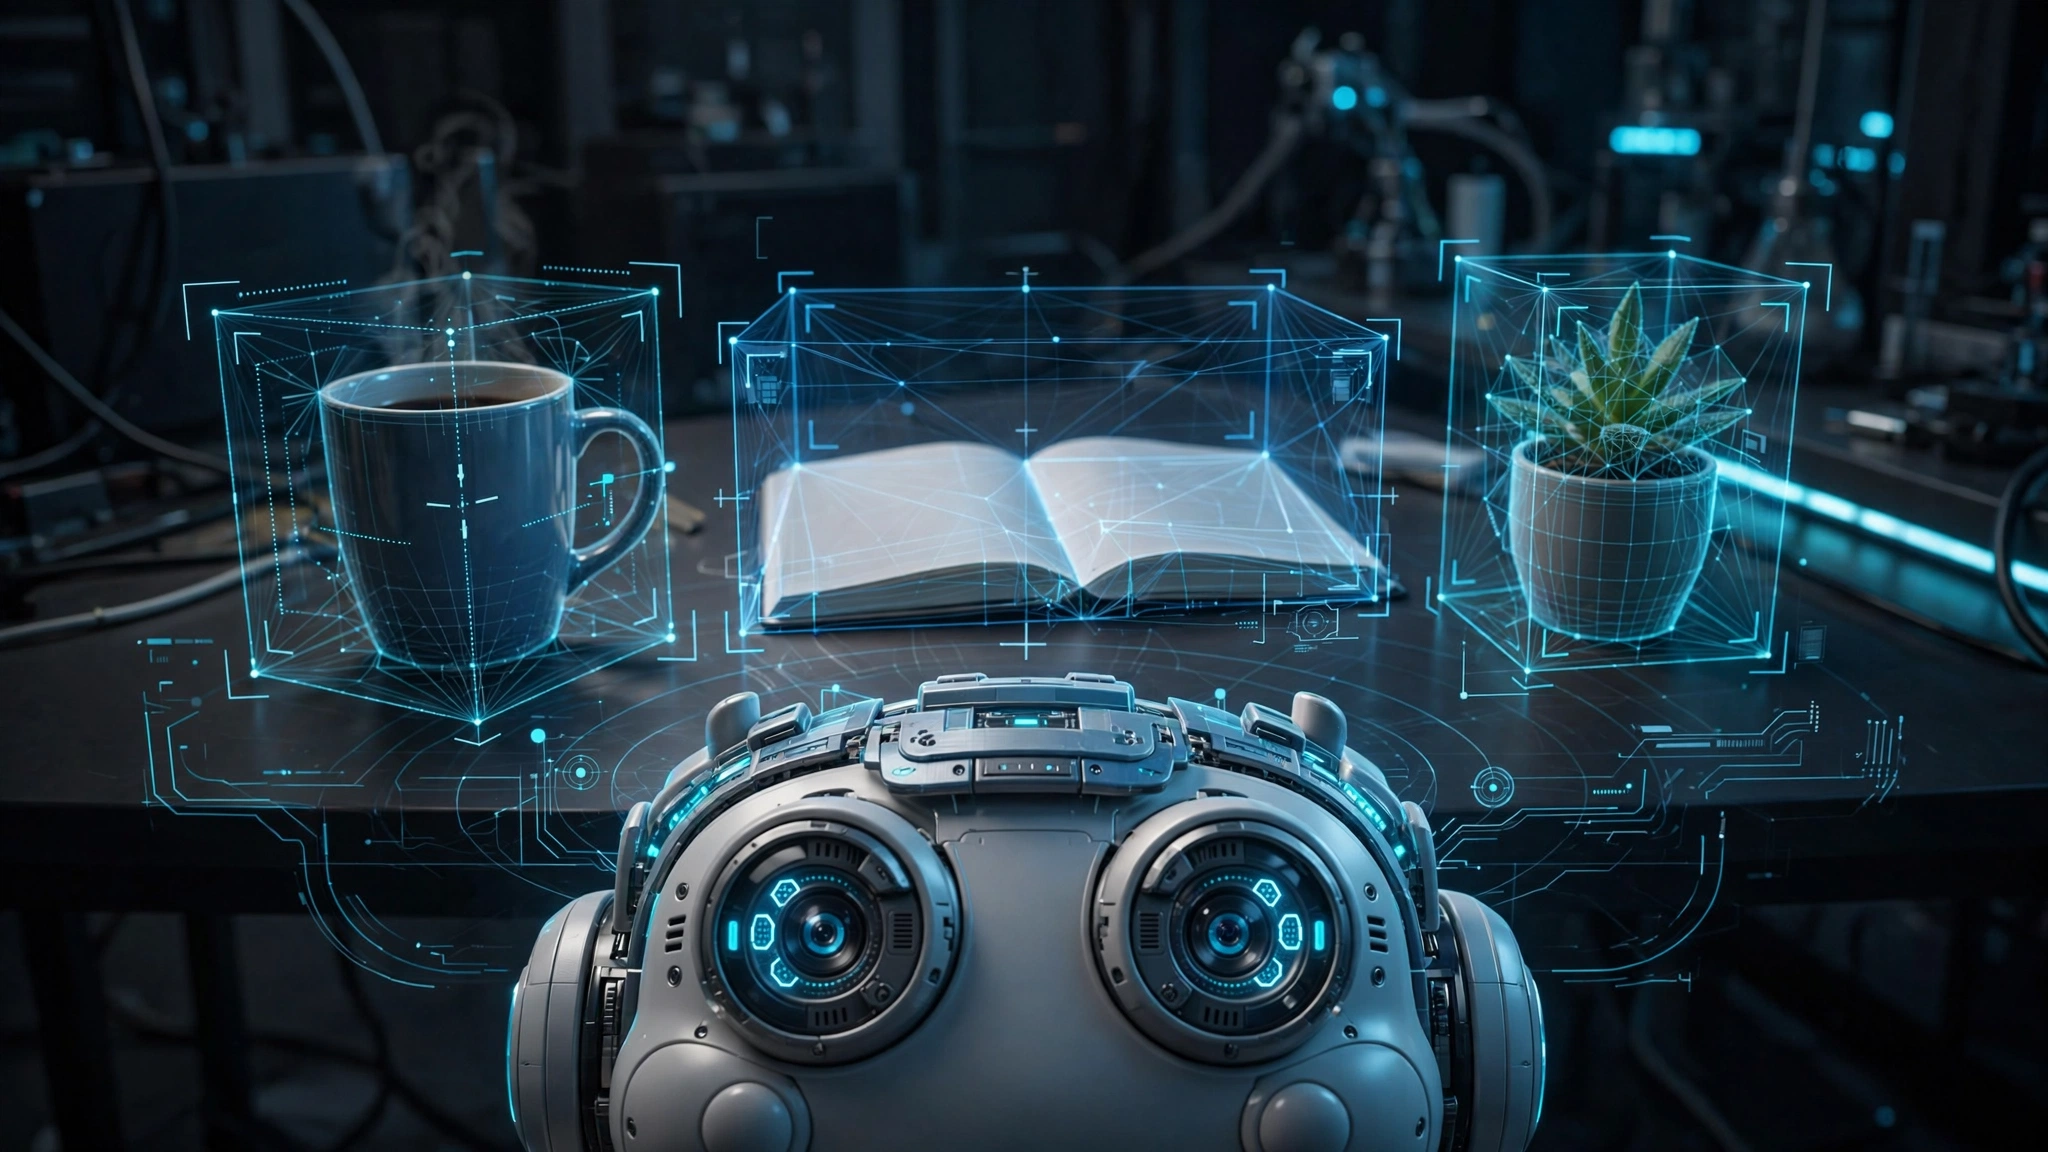
JBR-001 的计算机视觉系统
JBR-001 的计算机视觉系统

JBR-001 由 syntheticAIdata 打造,并与 Arduino 官方合作推出,是一款开源的 3D 打印桌面伴侣机器人,核心是 Arduino UNO Q 主板。麻雀虽小,五脏俱全:

  • 眼睛:头部装了一颗通过 USB-C 扩展坞接入的摄像头,视觉模型可以直接跑在 UNO Q 上,它不只能感知「有东西靠近」,还能认出眼前摆的是什么物体,再决定怎么反应;
  • 耳朵与触感:背部有一颗 Modulino 距离传感器,持续测量附近物体的距离——有人靠近时,它会转头、挥动手臂、切换显示屏上的动画,或者用 Modulino 蜂鸣器吹一段小调;
  • 身体:机身全部由 3D 打印件构成,装下主板和电子件;三个舵机分别控制头部旋转和两条手臂,舵机用独立外部电源供电,不抢主板的电;
  • 开放程度:开源代码、可打印的 3D 文件、分步组装教程,连训练视觉模型的合成数据集都一并公开,全部挂在 Arduino Project Hub 上。

项目在 Hacker News 上引发了热烈讨论,Hackster 等创客媒体也在过去 24 小时内跟进报道。有趣的是,最高赞的评论并非吹捧,而是挑刺:「那几条会动的腿根本不会走路」;还有人翻出旧账——曾经的开源机器人项目 Otto DIY 被惠普收购后逐渐沉寂,担心 JBR-001 重蹈「开源起家、商业收编」的覆辙。

分析:为什么一台「玩具」值得认真对待

先说一个判断:JBR-001 重要的不是它现在能干什么,而是它把「物理 AI 开发」的门槛降到了什么位置。

第一,它证明了智能层已经「过剩」,瓶颈只剩物理接口。 视觉识别、物体检测这些能力,过去需要云端大模型和昂贵算力,现在一颗 UNO Q 级别的边缘主板就能跑。JBR-001 的视觉模型还是用合成数据训练的——连「标注数据」这个老门槛都被绕过去了。当智能变得廉价,稀缺的就是「能动的手和眼」,而这正是 JBR-001 提供的:一个不到 100 美元零件成本、可复现的物理接口。

第二,它复刻了树莓派的成功路径。 树莓派没有试图做一台「好电脑」,它做的是「人人买得起的实验平台」;JBR-001 也一样,它不承诺帮你叠衣服,它承诺的是:任何一个有 3D 打印机的创客,今晚就能开始折腾物理 AI。dev.to 上一篇分析文章说得透彻——今天在家里组装 JBR-001 的 tinkerer,就是明天写下一代物理 AI 应用的工程师。人才的漏斗,永远从便宜的玩具开始。

第三,开源社区的「挑刺」本身就是价值。 HN 评论区对「腿不会走」的吐槽、对商业化收编的警惕,恰恰说明这个项目进入了真实的技术讨论,而不是营销泡沫。一个健康的开源硬件项目,需要的正是这种不客气的早期反馈。

当然也要泼点冷水:桌面伴侣机器人的形态,历史上大多止步于「新鲜三天」——Anki 的 Vector、Cozmo 都曾红极一时,最终难逃抽屉命运。JBR-001 能否避免成为又一个电子宠物,取决于社区能不能在它身上长出真正的应用:比如把它当作视觉算法的低成本测试台,或者特殊教育、老人陪伴场景的原型机。

展望:当机器人开始「白菜化」

把视线拉远,JBR-001 不是孤例:加州大学伯克利的开源人形机器人 Humanoid Lite(硬件成本压到 5000 美元以下)最近也重回热度,HN 上「61 个可 3D 打印机器人」的合集帖曾引发轰动。谷歌 DeepMind 的 Eric Jang 甚至公开表示,新一代大模型已经让机器人的逆向图形学等能力大幅跃升,并向机器人研究者免费提供开源模型的 token。

一条清晰的链条正在形成:大模型提供智能 → 合成数据解决训练 → 3D 打印解决机身 → 开源社区解决迭代。JBR-001 恰好是这条链条上第一个「开箱即玩」的完整样本。

巨头们在云端和工厂里卷物理 AI 的终局,而真正的普及,可能始于无数个深夜的书桌——一台自己打印、自己组装、会转头看你的小机器人。树莓派当年也是这样开始的。

评论

…

「全球最好的 AI,金融尽调只能考 51 分」:9 人小团队拿下 3000 万美元,专卖 AI 的「金融训练场」

背景:钱堆不出的短板

过去两年,AI 圈流行着一种"大力出奇迹"的信条:更大的模型、更多的 GPU、更长的训练时间,就能换来更聪明的智能体。这套逻辑在写代码、做客服、写文案上确实奏效了。但在华尔街那间没有窗户的数据室里,它撞上了一堵墙。

投资银行和分析师的工作,是整个人类知识分工里最"不标准化"的那一类:你需要在一个 160 个文件的虚拟数据室里翻查资料,同时处理 9 个邮件 thread、4 份会议纪要,在交易条款不断变化的过程中,始终抓住最新指令,还不能漏掉任何一项必须保留的条款。这不是考记忆力,也不是考推理速度,而是一种在信息洪流中保持"契约一致性"的职业素养。现阶段,再贵的模型也还在裸考——而公开的、能真实模拟这种工作的训练场,几乎不存在。

这正是 Halluminate 试图填补的空白。这家 2024 年成立的旧金山小公司只有 9 个人:创始人 CEO Jerry Wu 曾在 Capital One Labs 做 AI,CTO Wyatt Marshall 与他同为康奈尔计算机系校友,团队 2025 年夏天刚从 Y Combinator 毕业。他们的生意不卖模型、不卖应用,卖的是让 AI 学会干金融活的"训练场"本身。

事件:3000 万美元 A 轮,四家顶级实验室已是客户

2026 年 10 月 1 日,Halluminate 宣布完成 3000 万美元 A 轮融资,由 Oak HC/FT 领投,公司累计融资达到 3850 万美元。跟投名单包括 Y Combinator、Orange Collective、Heavybit、FT Partners,以及来自 Anthropic、OpenAI、Meta 的研究人员个人天使投资——注意这份名单:客户和投资人几乎是同一批人,一张"客户即股东"的成绩单。

更值得玩味的是客户结构。公司透露,它的客户包括美国四家头部 AI 实验室,外加两家做浏览器智能体的头部公司。也就是说,当今最头部的模型厂商,训练"会干金融活"的智能体时,用的是这家 9 人公司的沙盒。

Halluminate 的产品分成三块:可托管的沙盒环境——智能体可以在里面像人类分析师一样点击、打字、浏览软件,搞砸了也没关系,环境一键重置回初始状态,完全不影响生产系统;自有评测基准——用来衡量模型在金融任务上的真实水平;专家评估服务——由真人交易员来裁判智能体的产出。公司还开源了一个叫 Westworld 的项目,把训练场的门槛进一步打低。

支撑这次融资的最大论据,是它在 8 月发布的一份基准测试:让七个前沿模型走完一套模拟的并购尽调流程,88 个任务全部基于匿名的真实私募交易、由在职交易员编写和审核。结果是:全世界最好的 AI,平均得分只有 51%。

一道典型题目是这样:用一个 160 文件的数据室、21 封邮件(横跨 9 个邮件 thread)、4 份会议纪要,给一份工作说明书做修订标记(redline)。交易条款在中途发生变化,智能体必须识别最新指令,同时保留那些本就该保留的条款。结果,智能体们集体暴露了"短记忆":漏掉必须的修改、用错分析方法、或者依据已经被取代的旧信息下结论——活生生的"带新员工还不如不带"。

这些失败模式被 Halluminate 转化成了强化学习环境:先测出智能体在哪里崩,再把崩溃的场景做成可以反复训练的沙盒。

分析:训练数据正在"垂直化"

Jerry Wu 对这件事的判断很激进:AI 的训练数据和训练环境,正在按行业裂变成一个个"垂直化数据研究实验室"(verticalized data research labs)。模拟投行家的工作,和模拟软件工程师的工作,在本质上是两件完全不同的事,未来会有公司分别在金融、代码、医疗等领域做深做透,而不是像今天这样"一碗大锅饭"通吃所有领域。

这个判断有三层现实依据:

第一,智能体的训练从"刷题"走向"实习"。大模型时代靠爬网页做预训练,智能体时代靠"干活"做强化学习。但让智能体在真实金融系统里练手是不可能的——一出错就是真金白银的损失。于是,谁拥有最逼真的"模拟考场",谁就掐住了智能体进化的咽喉。Halluminate 的沙盒,本质上就是金融智能体的"驾校考场"。

第二,评测即权力。88 个任务、51% 的平均分,这组数字本身就是一张名片:它定义了"金融智能体行不行"的标准。历史上,MMLU、HumanEval 这些基准定义了大模型的竞赛规则,谁制定基准,谁就拥有话语权。Halluminate 正在把同样的逻辑搬到金融垂直领域,而它的客户恰好是制定通用基准的同一批实验室。

第三,小团队的杠杆正在变大。9 个人、一年多时间,靠一套沙盒+基准,就切进了头部实验室的供应链。这背后是 AI 基建链条的分工细化:当模型训练进入"后预训练"阶段,数据工程、环境工程、评估工程成为新的稀缺品。专精一个小切口,比什么都做更值钱。Anthropic、OpenAI、Meta 研究员个人参投,相当于用真金白银投票:他们也认为,下一代模型的能力增量,将来自这种垂直化训练环境。

当然风险也很清晰:基准一旦被"刷榜",权威就会流失;大实验室完全有能力自建训练场,Halluminate 的护城河取决于它能否持续产出更难、更新、更贴近真实交易的模拟环境——这是一场和客户赛跑的游戏。

展望:金融 AI 的"分水岭"

Halluminate 的故事,标志着金融 AI 进入了一个新阶段:问题不再是"模型够不够大",而是"训练场够不够真"。当全球最好的 AI 在模拟尽调里只能拿 51 分,意味着华尔街的自动化才刚刚起步——而谁先把智能体"练"到 90 分,谁就掌握了下一个十年的定价权。

对国内的启示同样直接:金融数据天然敏感、合规门槛极高,真实交易数据出不了内网。这意味着,谁拥有合规、脱敏、高质量的垂直训练环境,谁就能在金融智能体的赛道上抢到先机。Halluminate 的 3000 万美元,买的不是模型,而是一张"考场建设许可证"。这张许可证,在任何一个有金融野心的市场,都值得一张对等的入场券。

评论

…

「420 亿美元的左手倒右手」:博通借给 Anthropic 巨款租自家芯片,AI 圈的「循环融资」玩到了新高度

题图
题图

背景:IPO 招股书里藏着的「重量级关系」

9 月底,Anthropic 向美国证监会秘密递交 IPO 注册文件的消息震动了整个科技圈:一家年营收不到 50 亿美元、运营亏损却超过 80 亿美元的公司,竟然把目标估值定在了 2 万亿美元以上。但这份招股书里真正让华尔街倒吸一口凉气的,不只是天文数字的估值,而是它和一家芯片巨头之间错综复杂到近乎「共生」的关系。

10 月 1 日,路透社独家披露了招股书中的关键细节:博通(Broadcom)已经同意向 Anthropic 提供最高 420 亿美元的贷款,专门用于资助后者的基础设施支出。这不是一笔普通的企业贷款——它的结构、规模和时机,都把 AI 行业正在蔓延的一种新型融资游戏推到了聚光灯下。

要理解这笔交易的重量,得先看懂博通在 AI 版图中的位置。这家以芯片设计见长的半导体巨头,是谷歌 TPU 多代产品的幕后功臣:从第一代 TPU 开始,博通就与谷歌深度合作设计这些为 AI 训练和推理量身定制的芯片。而今年 4 月,Anthropic 宣布扩大与博通和谷歌的三方合作,从 2027 年起获得数吉瓦规模的下一代 TPU 算力。现在,博通又加上了第四重身份:Anthropic 的「银行」。

事件:420 亿可转债,覆盖三分之一算力账单

根据招股书披露,这笔融资将以可转换票据(convertible notes)的形式发放。几个关键条款值得细品:

首先,规模精确地卡在 Anthropic 算力账单的「三分之一」处。Anthropic 为未来五年租赁 TPU 算力容量做出的承诺高达 1252 亿美元,而博通的 420 亿美元信贷额度恰好能覆盖其中约三分之一。这不是巧合——它意味着博通这笔钱从设计之初就是冲着自家芯片的订单去的:Anthropic 拿着博通的钱,去租用由博通参与设计的 TPU 算力。

其次,可转债的设计让博通「进可攻、退可守」。如果 Anthropic 的 IPO 如期推进、估值继续膨胀,这些票据可以转换成 Anthropic 的股权,博通就从债权人变成了股东,吃到上市红利;如果情况不妙,博通至少手握债权。招股书还提到,博通有权指定一家融资合作伙伴共同参与,而 Anthropic 则表示,在 IPO 完成之前预计不会出售任何票据——这笔钱是 IPO 之后的「弹药」,不是现在的「救命钱」。

第三,交易附带了让华尔街皱眉的风险条款。Anthropic 在文件中主动披露了潜在利益冲突:博通既是硬件供应商又是融资方,它在定价和硬件供应上的决策,可能直接影响 Anthropic 能否获得足够的算力。更关键的是,某些付款或履约违约情形可能触发租赁义务加速到期,并限制这 420 亿美元额度的使用。换句话说,万一 Anthropic 的商业化跟不上烧钱速度,这笔「及时雨」可能瞬间变成「催命符」。

数字背后是 Anthropic 惊人的资金胃口:2025 年营收约 46 亿美元,运营亏损超 80 亿美元;未来几年云与算力采购承诺累计 5180 亿美元;另有一笔 150 亿美元的循环信贷额度正在谈判中。早在今年 4 月,Anthropic 就已经向一个以博通为受益人的限制性账户存入了现金——这桩「婚事」其实已经筹备了半年。

事件图
事件图

分析:为什么「左手倒右手」成了 AI 时代的标配?

博通借钱给 Anthropic、Anthropic 用这笔钱租博通参与设计的芯片、Anthropic 顺势成为博通 2027 年最大的算力客户——这个闭环,被外媒称为 AI 行业「循环融资」(circular financing)最清晰的样本。罗斯柴尔德公司的管理合伙人 Robert Leitao 对路透社的评论一针见血:「现在市场似乎在下一场高度集中的赌注,赌这两家公司能产生足够的收入,来支撑已经发生的所有融资。」

这种模式为什么会在 AI 行业集中爆发?答案藏在算力的特殊属性里。

第一,算力是 AI 时代的「石油」,但油田的建设周期极长。从芯片流片到数据中心通电,动辄两三年。供应商(博通)需要提前锁定需求才敢扩产,客户(Anthropic)需要提前锁定产能才敢向投资人讲增长故事。传统的「一手交钱一手交货」在这种超长周期、超大规模的军备竞赛面前失灵了——于是供应商干脆自己下场做银行,用融资把未来的订单「预支」成现在的合同。

第二,可转债是这种博弈的「最优解」。对博通而言,它既锁定了 Anthropic 成为 2027 年最大客户(招股书明确预期),又保留了分享 IPO 上涨的期权价值;对 Anthropic 而言,它用未来的股权预期换取了当下的算力确定性,而不必在 IPO 前稀释股份。这是一种典型的「用明天的钱,买今天的确定性」。

第三,风险被精巧地分散了,但没有消失。博通可以引入融资合作伙伴分担 420 亿的敞口;Anthropic 把动用时点推迟到 IPO 之后,先用上市募资充实资产负债表。但华尔街怀疑论者的担忧依然成立:Anthropic 一年烧掉 80 多亿美元,如果 Claude 的商业化收入增速跟不上 1252 亿美元租赁承诺的节奏,这个资金链条上的每一环——博通的贷款、谷歌的 TPU 产能、Anthropic 的 IPO 估值——都会同时承压。这正是「AI 泡沫论」最喜欢引用的论据:增长看起来像是靠资产负债表「印」出来的,而不是靠利润「赚」出来的。

值得注意的是,博通自己也把赌注押得很大。据路透社援引的数据,博通的 AI 半导体收入目标是 2027 财年约 1150 亿美元、2028 财年约 2300 亿美元。当一家公司的核心增长目标与单一客户的信用深度绑定,分析师们看财报的眼光就不得不从「产品周期」切换到「银行风控」:客户集中度、合同可执行性、对手方违约时的连锁反应,这些原本属于银行业的问题,现在成了芯片股投资者必修课。

当然,也要看到硬币的另一面。云计算早期,设备商为电信运营商提供「供应商融资」(vendor financing)是行业惯例,它帮助整个产业链跨越了资本开支的死亡谷。今天的 AI 算力基建,本质上正在经历同样的阶段——只是量级从几十亿美元膨胀到了几百亿。博通不是在「送钱」,而是在用金融工具为自己的芯片路线投票。

展望图
展望图

展望:算力军备竞赛进入「金融工程」阶段

这笔交易如果顺利落地,将标志着 AI 基建竞赛进入一个新阶段:拼的不只是芯片性能和模型能力,还有金融工程的创造力。谁能设计出更精巧的融资结构,谁就能在算力短缺的时代抢到更多的「石油」。

对 Anthropic 而言,IPO 之后的剧本已经写好:上市募资 + 420 亿可转债 + 150 亿循环信贷,三重弹药加起来,足够支撑它未来几年的算力开支。但这也意味着,Anthropic 的命运将与博通的 TPU 路线图深度捆绑——如果下一代 TPU 的性能或交付出现波折,Anthropic 几乎没有 Plan B。

对行业而言,「博通模式」很可能被复制。英伟达已经通过多种形式深度参与客户的融资,AMD、Marvell 等芯片公司大概率会跟进。未来的 AI 芯片竞争,可能会演变成「芯片 + 融资方案」的打包竞争:谁给的信贷额度更大,谁的芯片就更好卖。

监管的目光也值得关注。美国联邦贸易委员会已经对 AI 智能体的消费者风险展开调查,这种供应商同时扮演「债权人 + 最大客户」的深度绑定,是否会在某个时点触发反垄断审查,还是个未知数。Anthropic 在招股书里主动披露利益冲突,某种程度上也是在为未来的监管问询「打预防针」。

最后,回到 Leitao 的那句评论。这场 420 亿美元的赌局,赌的是一个简单到近乎朴素的信念:AI 带来的收入增长,最终会大到足以覆盖今天所有的融资、所有的租赁承诺、所有的估值。如果这个信念是对的,博通和 Anthropic 都将名利双收;如果错了,那么今天这份招股书里的每一个数字,都会成为未来商学院案例里的警示注脚。

算力时代的军备竞赛,从来不只是工程师的战争。现在,银行家也正式入场了。

评论

…

「合同1034亿,营收1.4亿」:Nscale 拿下 34 亿美元预融资,欧洲最大 AI 基建 IPO 箭在弦上

欧洲AI数据中心夜景
欧洲AI数据中心夜景

背景:一家「两岁」的公司,要替欧洲补上 AI 基建的课

在 AI 算力这场全球竞赛里,欧洲长期是个「看客」:模型有 Mistral,芯片靠英伟达美国发货,真正的大规模 AI 数据中心却屈指可数。Nscale 就是冲着这个缺口来的。

这家伦敦公司 2024 年 5 月才成立,创始人是 Josh Payne 和 Nathan Townsend,前身是墨尔本一家加密货币挖矿公司 Arkon Energy 的分拆——挖矿的机房和电力,摇身一变成了 AI 算力的底座。成立两年多,Nscale 走了一条「垂直整合」的路:从电力、数据中心、算力硬件,一路做到上层的编排软件,目标是把 AI 基础设施的每一层都捏在自己手里。

资本市场对这个故事相当买账:2024 年 12 月 1.55 亿美元 A 轮;2025 年 9 月 11 亿美元 B 轮;2026 年 3 月 20 亿美元 C 轮,投后估值 146 亿美元,被称为「欧洲史上最大的一轮融资」。英伟达、戴尔、诺基亚都是它的股东,微软则是它的大客户。

事件:IPO 前夜,先借 34 亿美元「压阵」

据彭博社报道,Nscale 在上市前又锁定了一笔 34 亿美元的 pre-IPO 融资。这笔钱的结构很有讲究:

它不是股权,而是一笔可转债,由对冲基金 Third Point 领投,英伟达、Apollo、Citadel、Hudson Bay Capital、阿布扎比投资委员会和 8090 Industries 跟投。认购协议在 9 月 15 日签署,三天后(9 月 18 日)公司向美国 SEC 递交了 IPO 招股书,计划在纽交所上市,股票代码 NSCL。

34 亿美元分成两部分:24 亿美元的公开 tranche,加上英伟达单独承诺的 10 亿美元(预计 11 月 16 日左右交割)。IPO 完成时,这些票据按约定转成普通股,英伟达拿的是无投票权股票——既加注,又不碰公司治理的红线。

最精妙的是转股价设计:转换价格相对 IPO 发行价有一个「两位数百分比」的折扣,而且这个折扣会随着公司估值爬升而加大,直到估值达到 300 亿美元后固定。翻译一下:投资者赌的是 IPO 定价越高、自己赚得越多,而公司则用这个机制把大机构提前「锁」进了上市的基本盘。

承销阵容同样豪华:高盛、摩根大通、摩根士丹利担任联席主承销商,另有 19 家银行参与。媒体报道的目标估值在 300 亿到 350 亿美元之间。

GPU服务器机房走廊
GPU服务器机房走廊

招股书里最抓眼球的数字,是「合同客户价值」:截至 8 月底达到 1034 亿美元,而 2025 年底这个数字还是 380 亿美元。其中最大的一笔,来自 8 月 25 日与 Anthropic 签署的协议——约 446 亿美元,覆盖其在西弗吉尼亚州 Monarch Compute Campus 的专用 GPU 基础设施。

微软的单子也不小:在挪威纳尔维克共建价值 62 亿美元的 AI 园区,并提供 20 万颗英伟达 GPU,《金融时报》称这笔交易可能带来 140 亿美元收入。公司还披露,自有和可控的电力管道在不到两年半里从 750 兆瓦扩张到超过 10 吉瓦——电力,才是 AI 基建真正的入场券。

但另一面同样刺眼:2026 年上半年营收 1.406 亿美元(去年同期仅 1040 万美元,涨了 12.5 倍),净亏损却从 3.689 亿美元扩大到超过 10 亿美元。招股书还主动披露了「内部财务控制存在重大缺陷」。此外,公司计划在 IPO 前后完成对 Anyscale(分布式计算框架 Ray 的开发商)的收购,补上软件编排这块拼图。

董事会名单则星光熠熠:Meta 前 COO 谢丽尔·桑德伯格、前雅虎总裁苏珊·德克尔、英国前副首相尼克·克莱格,以及 OpenAI 前高管菲吉·西莫。

分析:一场「用未来换现在」的豪赌

第一,IPO 前的可转债,是华尔街的「定心丸」。上市前夜发可转债,本质是让最有信息优势的机构先「打折上车」,换取它们在 IPO 时的托底承诺。折扣随估值爬升而加大的设计,把投资者和公司的利益彻底绑在了一起:定价越高,双方赚得越多。这在 AI 基建 IPO 里已成标准动作——CoreWeave 2025 年 3 月登陆纳斯达克之前,走的也是类似的路。

第二,1034 亿美元合同 vs 1.4 亿美元营收,是这场 IPO 最大的悬念。合同价值是未来的「期权」,营收才是现在的「现金」。Anthropic 一家就占了合同总额的 43%,客户集中度风险不容忽视。华尔街愿意为「未来」付 300 多亿美元,赌的是 Nscale 能把合同一栋一栋变成机房、把机房一颗一颗点亮 GPU。交付能力,是这家公司上市后每一个季度的必答题。

第三,垂直整合是欧洲玩家的唯一活路。美国不缺算力,欧洲缺的是「从电到卡」的一整条链。Nscale 把 Stargate Norway(目标 2026 年底 10 万颗 GPU,OpenAI 是初始客户)这样的项目和 Aker 的能源资产绑在一起,再收购 Anyscale 补上 Ray 编排层,打的是一套组合拳。对手也不弱:CoreWeave 已上市,Nebius、Lambda 紧追,Crusoe 刚以 309 亿美元估值融了 39 亿美元。AI 云的「独立战争」,欧洲战场正式开打。

展望:10 月的窗口,留给乐观者的时间不多了

从时间表看,Nscale 的上市窗口大概率落在 10 月到 11 月。它将和 Anthropic(目标估值 2 万亿美元,已秘密递交 IPO 文件)一起,构成今年四季度科技 IPO 的「双子星」。如果 Nscale 能按 300 亿美元以上估值成功上市,将是欧洲科技公司赴美上市的里程碑,也会给一众 AI neocloud 的估值再添一把火。

但风险同样真实:亏损在扩大、内控有缺陷、近半合同押注在 Anthropic 一家身上。路透社 Breakingviews 的评论一针见血:这场上市「把 AI 乐观主义的限度推到了极致」。

到底是欧洲 AI 基建的「诺亚方舟」,还是一场用 1034 亿美元合同讲出的精美故事?纽交所的钟声会给出第一个答案。

电路金线城市夜景
电路金线城市夜景

评论

…

「8 颗变 220 颗」:Volantis 拿下 8800 万美元,用 iPhone 的激光给 AI 芯片「搭桥」

题图 AI 生成示意图:中央计算芯片以激光光束连接周围的内存芯片——Volantis 的「光互连」愿景。
背景:AI 芯片的「最后一公里」难题

过去两年,AI 硬件的叙事几乎全是关于「算力」:英伟达一颗 GPU 卖出天价,订单排到两年后,AMD、博通、Marvell 一众厂商都在堆计算性能。但所有买卡的人都知道一个公开的秘密——真正卡脖子的不是计算单元,而是内存。

一颗 AI 芯片要跑大模型,必须把数千亿参数随时「喂」给计算核心。英伟达和 AMD 的解决方案是把昂贵的高带宽内存(HBM)紧紧围在计算芯片周围,用极细的电线把它们连起来。问题是,电线的传输距离是物理上限:走得太远,信号衰减、功耗和延迟都扛不住。结果是,即使英伟达最顶级的产品,一块 GPU 旁边也只能围 8 颗内存芯片。再往上加,不是造不出来,是「连不上」。

这就是 AI 硬件圈著名的「内存墙」:算力翻了几十倍,内存容量和带宽却原地踏步。推理越大模型、做越长的上下文,瓶颈越明显。业内对此有个共识判断——AI 的下一场革命,不会发生在计算核心上,而会发生在「计算和内存之间那几毫米的距离」上。

事件:旧金山初创 Volantis 宣布 8800 万美元 A 轮融资

10 月 1 日,总部位于旧金山的半导体初创公司 Volantis 宣布完成 8800 万美元 A 轮融资,把「内存墙」问题推到了聚光灯下。

本轮融资由 Stripe 老兵 Lachy Groom 和 Abstract Ventures 联合领投,跟投方包括风投传奇人物 John Doerr、VXI Capital、Triatomic 和 Susa Ventures。更耐人寻味的是天使投资人名单:AI 播客 Dwarkesh Patel、AI 芯片老兵 Naveen Rao、Anthropic 研究员 Sholto Douglas——一个横跨创投、芯片工程和前沿模型的「梦之队」,押注的是一家名不见经传的初创公司。

Volantis 的方案听起来近乎「降维打击」:别再用电线连内存了,改用激光。

公司正在开发一种光子互连技术,用激光光束在计算芯片和内存芯片之间传输数据,从而彻底摆脱电线「传输距离」的物理限制。按公司的说法,这套方案能让一块 GPU 周围挂载的内存芯片数量从 8 颗飙升到 220 颗——27 倍的增长。

而最妙的部分在于,它用的激光器并不奇异:VCSEL(垂直腔面发射激光器),正是 iPhone 人脸识别模块里那颗小激光器背后的技术。过去十年,苹果为了 Face ID 在 VCSEL 供应链上砸下重金,如今这条供应链已经成熟到可以「拿来即用」。Volantis 的思路是:不发明新东西,把已经大规模量产的成熟元件重新组合,解决 AI 芯片最痛的瓶颈。

公司 CEO 兼联合创始人 Tapa Ghosh 在接受路透社采访时说得非常直白:「先进封装永远值得尊重——它绝不简单。但它也不是什么前所未有的新东西。如果我们的项目成功了,没人会因此拿诺贝尔奖,但好消息是,他们也不需要拿。」

根据 FinSMEs 的报道,Volantis 正在开发的产品代号为 A-1,核心是「光子内存架构」:计算芯片通过定制微型 VCSEL 组成的光子光学织物(photonic optical fabric)连接内存,目标是让超过 20 万亿参数的模型以每用户每秒 1 万 token 的速度运行。公司计划明年交付首款芯片,首批瞄准的场景是 AI 编程这类对速度极度敏感的工作负载。

VCSEL 特写 AI 生成示意图:微型 VCSEL 激光器阵列——这项 iPhone 人脸识别同源技术,如今被用来连接 AI 芯片与内存。
分析:为什么这笔钱值得注意

首先,这是「内存墙」赛道今年最大的一笔早期融资之一,而且押注逻辑极其务实。当整个行业都在追逐 3nm、2nm 制程和更激进的先进封装时,Volantis 反其道而行之:用成熟供应链做组合创新。苹果用十年时间把 VCSEL 的成本打下来、把良率提上去,Volantis 相当于站在苹果的肩膀上摘果子。这种「借力成熟产业」的打法,历史上屡试不爽——特斯拉早期用笔记本电脑的 18650 电池造电动车,是同一个剧本。

其次,投资人名单本身就是信号。John Doerr 是 Netscape、谷歌、亚马逊的早期投资人,Naveen Rao 是 Nervana Systems(被英特尔收购)的创始人、AI 芯片圈的老兵,Sholto Douglas 来自 Anthropic 的研究一线。当「懂钱的」「懂芯片的」「懂模型的」三方同时下注,说明这件事在技术可行性和市场需求两个维度都通过了苛刻的尽调。

第三,时机踩在了「推理时代」的节拍上。2026 年的 AI 硬件叙事已经从「训练」转向「推理」:模型要真正赚钱,靠的是每秒吐出多少 token、每个 token 成本多少。而推理恰恰是内存带宽最敏感的场景——decode 阶段几乎完全被内存带宽决定速度。Volantis 把目标定在「20 万亿参数、每秒 1 万 token」,直接对准了推理云服务商的钱包。

当然,风险同样真实。220 颗内存芯片的愿景目前还停留在 PPT 阶段,首款芯片要明年才交付;光子互连的良率、功耗、与现有 GPU 生态的兼容性,都是未知数。更重要的是,英伟达自己也没闲着——NVL72 机架、第六代 NVLink、定制 HBM,巨头在内存问题上的投入只会更大。Volantis 的窗口期,就是在大公司把光互连做成熟之前,先把产品送到客户手里。

值得一提的是,这已经是今年第二家拿到大额融资的光互连玩家:9 月底 CScale 刚拿下 1.45 亿美元做数据中心级光互连(英伟达和英特尔都参投了)。两家公司的分野很清晰:CScale 解决的是「机架与机架之间」的光连接,Volantis 解决的是「芯片与内存之间」的光连接。一内一外,光子学正在从两个方向同时吃掉铜线的地盘。

展望:铜线的黄昏,光的时代?

如果把 AI 硬件史拉长看,每一次代际跃迁都伴随着一次「互连革命」:从板级总线到片上网络,从电互连到 NVLink。如今铜线在芯片-内存这段「最后一公里」上撞上了物理天花板,光子学接棒几乎是必然——唯一的问题是谁先做出来、做到多便宜。

Volantis 的 8800 万美元,买的是一个可能性:用 iPhone 里那颗小激光器,撬动 AI 芯片架构的下一次重构。明年首款芯片交付时,我们就能知道,这到底是「诺贝尔奖不需要」的工程务实,还是又一个停留在实验室里的漂亮故事。

但至少有一点已经确定:AI 竞赛的下一个战场,不在更大的模型,也不在更小的制程,而在那束连接计算与内存的光里。

未来数据中心 AI 生成示意图:未来的 AI 数据中心——中央处理器与数百颗内存模块以光束织成网络。

本文为原创整理,信息来源:路透社(Stephen Nellis 10/1 报道)、FinSMEs、Times New、Economic Times 交叉核对。

评论

…

「从造空调到救 AI 工厂」:LG 豪掷 1500 亿韩元在弗吉尼亚建冷水机工厂,数据中心散热大战正式打响

液冷数据中心
液冷数据中心

算力竞赛打了几年,人们才发现:真正卡住 AI 数据中心的,可能不是芯片,而是「热」。

10 月 1 日,LG 电子宣布将投资总计 1500 亿韩元,在美国弗吉尼亚州温莎市建设一座专供 AI 数据中心使用的冷水机工厂,并同步扩建韩国平泽、昌原的产线。同一周前,LG 刚刚拿下英伟达 AI 生态的「入场券」——成为 NVIDIA Partner Network 的电力与冷却方案优选合作伙伴。一家造家电起家的公司,正在把自己重新定义成 AI 基建的「散热承包商」。

背景:算力越热,散热越贵

过去两年,全球科技巨头围绕 GPU 的军备竞赛已经讲了太多遍。但很少被提及的是:当单颗 GPU 功耗从几百瓦一路爬升、单个机柜功率密度动辄几十千瓦起步,传统的风冷早就摸到了物理天花板。

LG 在其官方声明中援引的 TrendForce 数据给出了一个清晰信号:AI 芯片的液冷渗透率将从 2024 年的 14% 飙升至 2027 年的约 60%。市场研究机构 Omdia 的预测则更宏大——全球数据中心所需电力容量将从今年的 226 吉瓦增长到 2030 年的 420 吉瓦,其中约 60% 将集中在北美。这意味着,散热不再是数据中心的「配套工程」,而是决定算力能否交付的核心环节。

此前已有诸多信号:谷歌把 TPU 送上天测试太空算力、亚马逊签下 20 年核电大单锁电、应用材料拉铠侠组队攻关下一代内存——AI 基建的竞争,早已从芯片本身蔓延到电、散热、水、土地这些「硬约束」。LG 这次出手,正是把赌注压在了其中最被低估的一环:怎么把热搬走。

事件:三步棋,一盘散热大棋

LG 这一轮动作可以拆成三步,每一步都踩在时间点上。

第一步:拿认证。 9 月 28 日,LG 电子宣布加入 NVIDIA Partner Network,成为电力与冷却方案优选合作伙伴。其 2.6 兆瓦冷却液分配单元(CDU)通过了 NVIDIA DSX Ready 认证——据 LG 称,这是目前所有 DSX Ready CDU 合作伙伴中冷却容量最大的一款;600 千瓦与 1 兆瓦型号也完成了英伟达的基础设施资格认证,覆盖冷却性能、故障切换与可靠性等严苛技术标准。CDU 是直接芯片液冷(DTC)系统的关键部件:冷却液经由它循环到紧贴 CPU、GPU 的冷板,把芯片产生的热量带走,再交还给数据中心级冷却基础设施。LG 还计划在 2026 年底前为 4.0 兆瓦 CDU 争取英伟达认证。

第二步:秀产品。 9 月 29 日至 30 日,在新加坡滨海湾金沙举行的 Data Centre World Asia 2026 上,LG 首次展出了「Hydronic Modular」模块化冷却系统:把泵、阀门、应急缓冲水箱和管道全部预装在一个 ISO 标准集装箱里,现场只需接上冷水机与管道,大幅减少焊接与现场组装工作量;算力扩容时,直接加模块即可,让投资与需求增长同频。同场亮相的还有磁悬浮无油变频涡轮冷水机(利用室外低温空气的「自然冷却」功能降低压缩机负荷)、风扇墙单元,以及正在研发中的浸没式液冷方案。LG 把这套组合称为「从芯片到冷水机」(Chip-to-Chiller)的全栈散热方案,并推出了用 AI 预测冷负荷、优化系统运行的 Data Center Cooling Manager。LG 能源解决方案的电池备援单元(BBU)与储能电池、LG CNS 的预制模块化数据中心也一并参展,俨然是一支「LG 基建集团军」。

第三步:建工厂。 10 月 1 日的重磅消息:LG 将在弗吉尼亚州温莎市新建冷水机工厂,建筑面积 3.2 万平方米、占地 17 万平方米,目标明年上半年投产,主要生产供应 AI 数据中心的风冷式冷水机。同时扩建韩国平泽与昌原产线。LG 选择弗吉尼亚的理由很直白:全球大科技公司的数据中心集中于此,就近生产能缩短供货时间、增强供应链稳定性。

冷水机工厂
冷水机工厂

分析:家电巨头的「第二增长曲线」,押的是算力的物理极限

这件事值得细品的有三层。

第一层:散热正在成为 AI 基建的独立赛道。 芯片厂卷性能、云厂商卷规模,但当机柜功率密度突破风冷极限,谁能把热高效搬走,谁就掌握了算力交付的「最后一公里」。CDU、冷板、浸没式液冷这些过去只在小圈子里讨论的设备,正在变成和 GPU 同等重要的采购清单项。LG 拿下英伟达 DSX Ready 认证,等于拿到了进入超大规模数据中心供应商名单的门票——这比单纯卖设备更重要,因为它是生态位。

第二层:传统制造巨头的转型范本。 LG 的优势恰恰在于「老本行」:压缩机、换热、流体控制、精密制造,这些家电时代积累了几十年的能力,几乎可以平移到数据中心冷却上。与纯粹的新创公司相比,LG 有现成的供应链、品控体系和全球交付网络;与传统精密空调厂商相比,LG 背后还有一整个电子与能源集团可以打组合拳(电池备援、模块化数据中心、AI 运维软件)。这是一种「降维打击」式的跨界:用消费电子的制造纪律,去做工业级的高毛利生意。

第三步棋的深意,则是地缘与供应链。 把工厂建在弗吉尼亚——北美数据中心最密集的区域——LG 赌的是「在地化供应」将成为北美 AI 基建的硬性要求。Omdia 预测 2030 年全球数据中心电力容量的六成在北美,谁先在当地落下产能,谁就先拿到订单。这与台积电评估在得州建第二座大型制造园区的逻辑如出一辙:AI 供应链正在从「全球分工」转向「贴近需求」。

当然,风险同样真实。液冷技术路线仍在快速演进,直接芯片液冷、浸没式液冷、甚至未来的新方案之间存在路线之争;LG 的 2.6 兆瓦 CDU 虽然拿下认证,但大规模出货的可靠性与成本仍需市场验证;而且 1500 亿韩元的投入相对动辄百亿美元的 AI 基建盘子并不算大,更像是一张「入场券」而非「决战兵器」。

芯片液冷
芯片液冷

展望:2027 年,散热决定算力天花板

如果 TrendForce 的预测应验——2027 年 AI 芯片液冷渗透率达到 60%——那么未来两年将是数据中心冷却行业的「产能军备竞赛」。LG 的时间表已经排好:明年上半年弗吉尼亚工厂投产、2026 年底前 4.0 兆瓦 CDU 争取英伟达认证、浸没式液冷方案持续推进。

更大的图景是:AI 竞赛的战场正在下沉。从模型到芯片,从芯片到电力,从电力到散热——每一层瓶颈被突破,下一层瓶颈就会浮现。当所有人都在谈论多少万亿参数、多少吉瓦算力时,LG 选择去解决那个最「物理」的问题:热量往哪儿去。

毕竟,算力可以租、模型可以蒸馏,但热力学定律,谁都绕不过去。

评论

…

「聊天聊着聊着,一家网店就开张了」:Shopify 推出 Canvas,AI 建站进入「整店可视化」时代

背景:建站这件事,门槛其实一直没被真正打掉

过去二十年,建站工具的承诺一直没变:让没有技术背景的普通人也能开一家网店。从 WordPress 主题、Squarespace 拖拽,到 Shopify 自己的无代码编辑器,进度条看起来在推进——选一个主题、拖几个模块、换几张图,网站就"上线"了。

但真正的分界线始终在那里:一旦你想做点"主题里没给的东西"——自定义的商品页布局、特殊的结算流程、品牌独有的动效——立刻就掉进代码世界,要么自己啃文档,要么花钱请开发者。Shopify 自家 AI 助手 Sidekick 过去一年已经在干这事:写代码、改主题、调应用,2026 年上半年它替商家改了超过 2500 万次主题文件。只是这些能力都散落在各处,没有一个统一的"工作台"。

Canvas 就是这个工作台。Shopify 10 月 1 日发布的这个新工具,等于把 Sidekick 从"后台助手"提拔成了"建站搭档":你动嘴,它动手,整个过程你看得一清二楚。

事件:跟 AI 聊天,20 分钟开出一家全定制网店

Canvas 的核心交互很简单:商家在聊天框里跟 Sidekick 说人话,比如"我要一家卖网球装备的店,风格要干净运动风,首页突出新品系列"。Sidekick 直接修改店铺的主题文件,Canvas 则把整个网站铺开展示——不是预览图,而是店铺真实代码渲染出来的页面,每一页并排呈现,可以平移缩放、点进任意细节查看。

这意味着你看到的即你得到的:页面带完整交互和动画,能换商品、换分类、换屏幕尺寸(手机/平板/桌面)实时查看效果,不再是"导出看看再改"的循环。更进一步,Sidekick 自己也会"看":它会在修改过程中截屏,用视觉反馈确认改得对不对,相当于给 AI 装上了一双眼睛。

细节上,Shopify 为 Canvas 做了两项底层准备:简化了主题架构,让 AI 更容易理解和修改店铺的结构、逻辑和设计;同时让 Sidekick 具备协调修改多个主题文件与模板的能力——一次指令可以横跨整个店铺做一致的改动,而不是逐页修补。商家仍然可以手动点选单个元素微调,但 Shopify 赌的是大多数人会直接告诉 Sidekick。

"12 年前我建 Kotn 的时候,我会写代码,但把一个粗糙的店铺跑起来还是花了两周。"Shopify 产品总监、本土服装品牌 Kotn 联合创始人 Ben Sehl 说,"今天,一个商家用 Shopify 二十分钟就能建出一家全定制的店铺,品质远超我当年那家。Canvas 就是让更多创业者更接近他们脑子里那个店铺的样子。"

Canvas 正在未来几天内陆续向商家推送。推出节奏上,它紧跟着 9 月 28 日 Shopify 向智能体开放结账环节(WebMCP)的动作——前端建站、后端结账,Shopify 正在把"代理式商务"的整条链路捏在自己手里。

分析:建站门槛归零之后,真正的较量才开始

Canvas 的对手一目了然:Wix、Squarespace、Webflow、Framer 这些 AI 建站工具,以及 Lovable、Replit 一类的 vibe-coding 平台。大家都在回答同一个问题——当建站变成聊天,建站工具的护城河是什么?

Shopify 的答案很"Shopify":护城河不在建站本身,而在建站之后的整套生意。Lovable 能帮你 10 分钟生成一个漂亮页面,但页面上线后呢?支付、库存、物流、结账、营销——Shopify 把这些全攥在手里。Canvas 让开店的摩擦降到零,WebMCP 让智能体能替你结账,两者叠加,Shopify 实际上在构建一个闭环:AI 帮你开店,AI 帮你卖货,AI 帮你收钱。对于 200 万商家来说,"开店"第一次从一个项目变成了一次对话。

但这条路上有三个真实的坑。其一是同质化:当所有人都用同一个 AI 聊天建站,店铺会不会长得越来越像?AI 的"审美均值回归"是所有生成式工具的通病,品牌差异化反而变得更贵了——贵的不是代码,是品味。其二是生态开发者的位置:Shopify 简化主题架构、让 AI 直接改文件,短期是效率,长期可能挤压主题开发者和建站服务商的生存空间——平台亲自下场抢了一部分生态的活。其三是早期产品的完成度:Shopify 自己也承认 Canvas 处于早期阶段。AI 改代码的幻觉、复杂品牌需求的理解偏差、出了问题谁背锅,这些都还需要在大规模真实使用中验证。

有意思的是一个时间巧合:9 月底刚有报道称亚马逊在"封堵"Meta 的购物智能体爬取商品页,Shopify 则反其道而行之——向智能体开放结账、向商家开放 AI 建站。两种路线,赌的是同一个未来:电商的下一个十年,到底是"平台围墙"赢,还是"开放接入"赢。

展望:从"建站工具"到"生意操作系统"

如果把视角拉远,Canvas 其实是 Shopify"Sidekick 化"战略的又一块拼图。过去一年,Sidekick 从写代码的助手,变成能改主题、建应用、做结账集成的全能选手;Canvas 则第一次给了它一个"身体"——一个可视化的工作台。下一步几乎可以预见:语音指挥建站、多智能体分工(一个管设计、一个管文案、一个管 SEO)、甚至根据销售数据自动优化店铺。

更大的问题留给整个行业:当开店的成本趋近于零,稀缺的就不再是"开店能力",而是"值得开的店"——选品、供应链、品牌故事。这些 AI 暂时还替代不了。但 Canvas 至少把第一道门槛拆掉了:从今天起,不会写代码、不懂设计、没预算请人,不再是你不开网店的理由。

对 Shopify 来说,这步棋的算盘也很清楚:开店的人越多,在它生态里沉淀的交易就越多。Canvas 免费降低的门槛,最终都会变成 GMV 和订阅费。这大概就是平台型公司的 AI 逻辑——AI 不是产品,AI 是获客。

评论

…