$tail -f ./life.log

Moments

Short photo-and-text notes of the now.

「不用 CUDA 也能跑大模型」:Janus 单文件二进制让本地 LLM 摆脱英伟达依赖
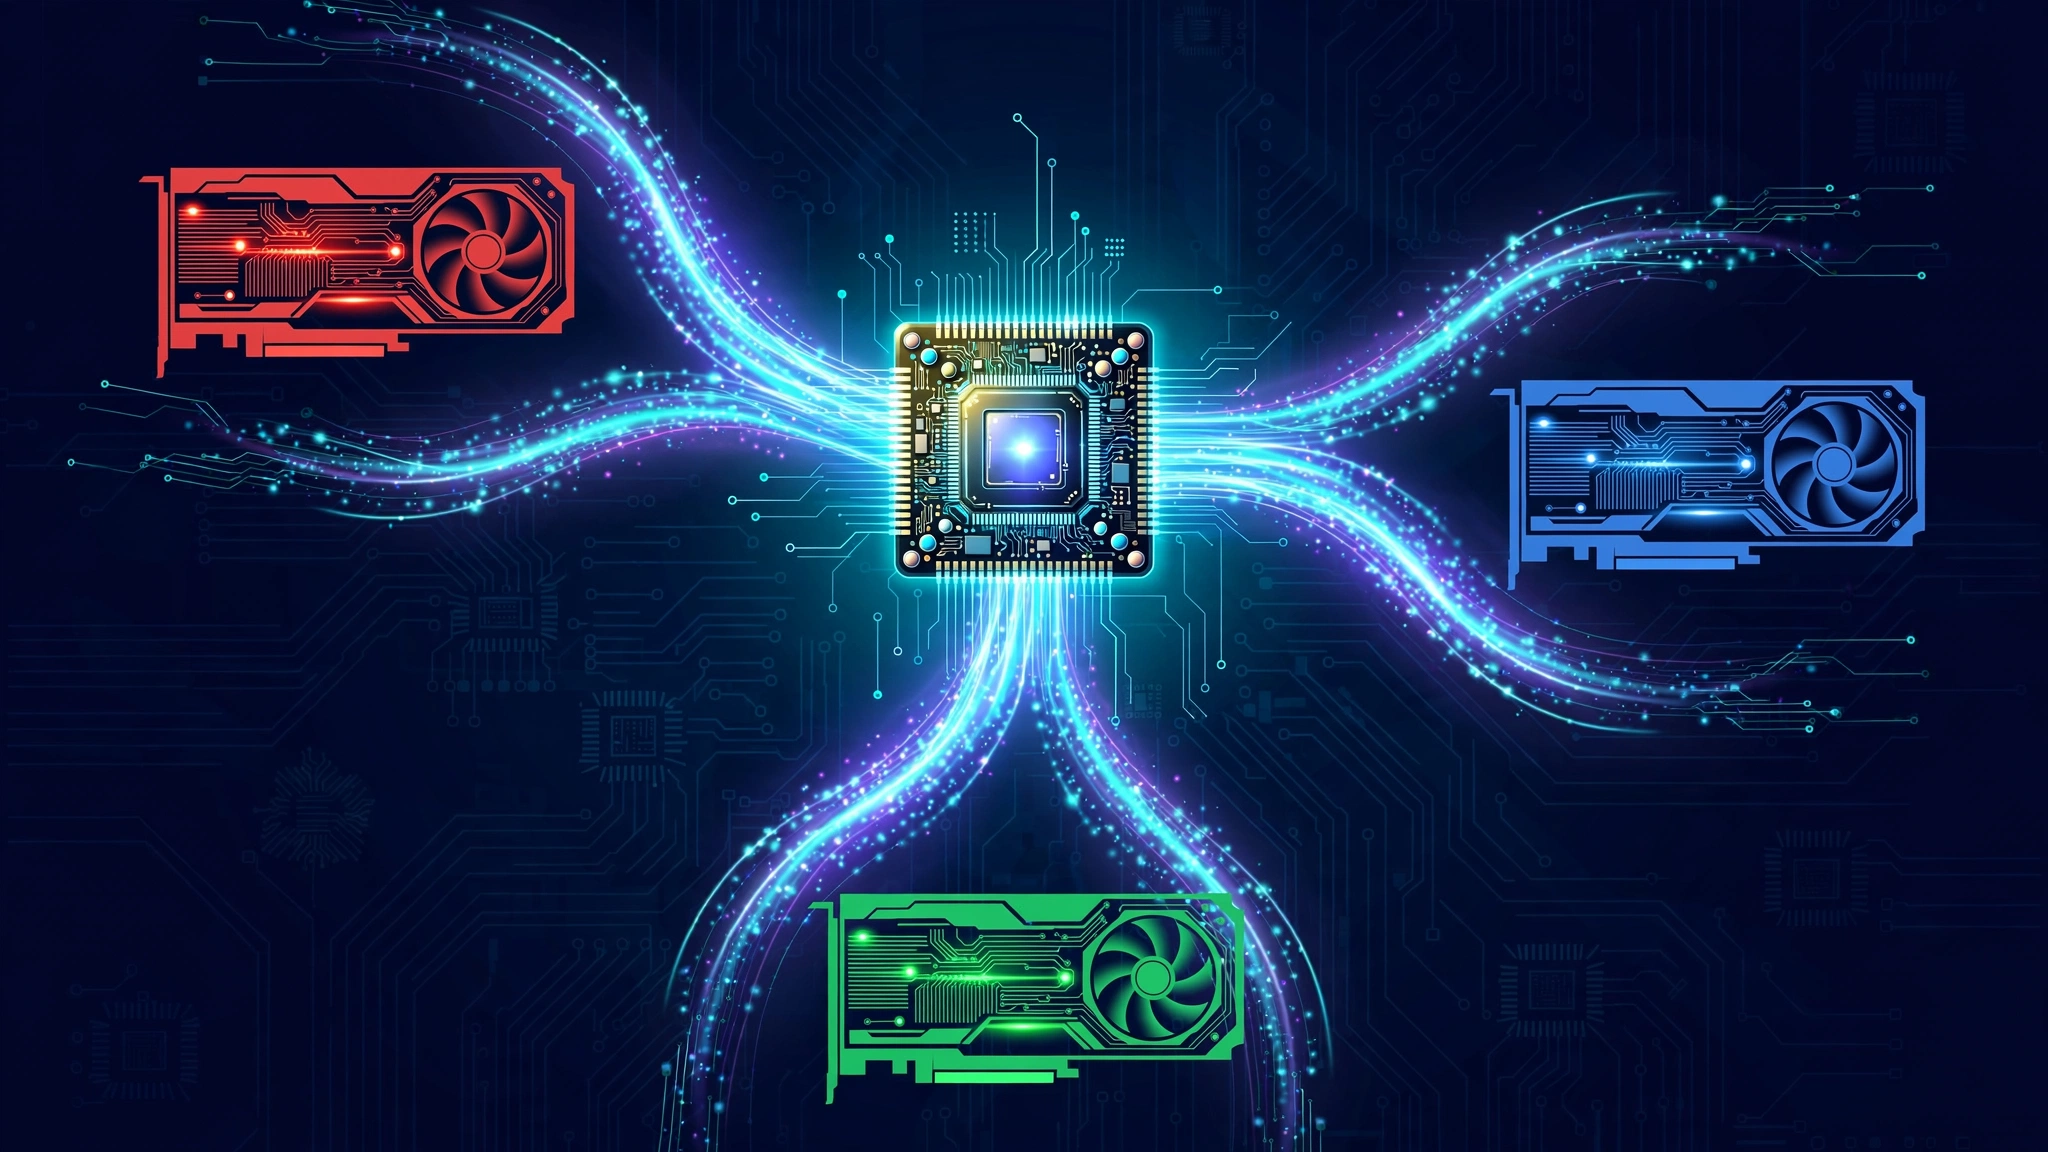
Janus 让本地大模型摆脱显卡绑定
Janus 让本地大模型摆脱显卡绑定

今天 Hacker News 上一个叫 Janus 的开源项目冲进了热榜前五:它只是一个 Go 语言编译出来的单个可执行文件,就能在你的电脑上跑起 GGUF 格式的大语言模型,而且不挑显卡——AMD、Intel、英伟达通吃,靠的是 Vulkan 而不是 CUDA。

背景:本地大模型的“英伟达税”

过去两年,“把大模型装进口袋”成了开发者圈最热的运动。Ollama、LM Studio 让普通人也能在笔记本上跑 Llama、Qwen 这些开源模型,数据不出内网,断网也能用。但这场运动有个隐形门槛:显卡必须是英伟达的。

原因很现实。llama.cpp 是本地推理的事实标准引擎,它对 CUDA 的支持最成熟、速度最快。而全球绝大多数 PC 用的却是 Intel 核显、AMD 显卡或笔记本集显——这些用户要么忍受纯 CPU 推理的龟速,要么去折腾 ROCm、SYCL、Vulkan 后端,编译参数复杂到劝退。换句话说,本地 AI 的“最后一公里”,被 CUDA 生态悄悄收了一道税。

事件:一个文件,跑遍三种显卡

10 月 2 日登上 Hacker News 首页的 Janus(GitHub:Vibra-Ingenn/Janus),思路简单粗暴:把复杂度全部藏进一个二进制里。

它做的事情有三件:第一,用 Go 写了一个本地 LLM 服务器,底层调用 llama.cpp 的 Vulkan 后端,一次覆盖 AMD、Intel、英伟达三家 GPU,实在没有独显就回退到 CPU;第二,对外暴露 OpenAI 兼容的 API(/v1/chat/completions、/v1/models),意味着 Cursor、Cline 以及任何 OpenAI 客户端都能无缝接上本地模型;第三,零依赖——Windows 下就是一个 .exe,不要 Python、不要 Docker、甚至不要先装 Ollama,模型文件(通常 2–8GB 的 .gguf)丢进文件夹就能跑,还支持不重启热切换模型、自动识别聊天模板、对“思考型”模型的 <think> 推理过程做结构化拆分。

作者还在仓库里自带了一个模型下载器,一条命令就能从 Hugging Face 拉取模型。整个上手路径被压缩成了:下载、放模型、运行。

HN 评论区很快出现了“灵魂拷问”:有人指出这本质上是对 libllama.so 的一层封装,推理性能大概率和 llama.cpp 上游持平;也有人提醒,Vulkan 在 Intel 硬件上的额外开销不小,“看到 Intel 被照顾我很激动,可惜只是 Vulkan”。这些质疑恰恰说明了一件事:大家争论的已经不是“能不能跑”,而是“跑得够不够快”——本地推理的可用性门槛,事实上已经被跨过去了。

分析:为什么一个“封装”也值得上热榜?
本地 AI 推理的跨显卡时代
本地 AI 推理的跨显卡时代

Janus 的技术含量确实不算颠覆,但它踩中了四个真实趋势。

第一,反 CUDA 锁定正在成为刚需。 数据中心可以只买英伟达,但消费端不行——存量 PC 里 Intel 和 AMD 才是大多数。一个不挑显卡的推理运行时,解决的是“本地 AI 到底为谁服务”的覆盖面问题。Vulkan 作为跨厂商的图形 API,天然就是干这个的,虽然它为 AI 推理优化的成熟度还不如 CUDA,但“能用”本身就是一种解放。

第二,Go 单二进制的分发哲学。 本地工具最大的敌人不是性能,是安装步骤。每多一个“先装 Python 3.11,再 pip install……”,用户就流失一批。Janus 把 Go 语言“一个文件走天下”的传统发挥到极致:拷贝即部署。这对企业内网、离线环境、边缘设备的意义尤其大——合规要求数据不出内网的场景,IT 部门最怕的就是依赖地狱。

第三,OpenAI 兼容 API 已成“水电接口”。 不管你用什么模型、跑在什么硬件上,只要接口长得像 OpenAI,整个工具链(IDE 插件、Agent 框架、评测脚本)都能直接复用。Janus 没有发明新协议,而是主动“长成”标准接口,这是小项目最聪明的生存策略:生态的复利,远大于自创轮子的快感。

第四,质疑声本身就是路线图。 Vulkan 在 Intel 上的开销、macOS 目前只有 CPU 后端、性能天花板取决于 llama.cpp 上游——这些短板都指向同一个方向:跨厂商推理栈还需要时间打磨。但方向一旦确立,优化只是工程问题。别忘了,llama.cpp 的 Vulkan 后端本身也在快速进化,SYCL、Metal、ggk(GGUF 官方的新引擎)等多条路线正在并行推进。

展望:本地推理的“去英伟达化”工具链正在成形
一个二进制,随处部署
一个二进制,随处部署

把视线拉远一点:Janus 不是孤例。从 llama.cpp 的多后端矩阵,到 GGUF 组织自研的 ggk 引擎,再到各类“一键包”启动器,本地推理正在经历一场静悄悄的基础设施民主化——核心命题是让每一块能算的芯片都能跑模型,而不是只有 CUDA 卡。

短期看,这类工具最大的价值是“把 10 步配置变成 1 个文件”,降低的是人的成本;长期看,当跨厂商后端性能追上来,硬件选择的权力会从云厂商和显卡厂商手里,部分回到用户手里。对普通开发者来说,最实在的建议是:如果你手头正好有一台非 N 卡的电脑,不妨试试这类新工具——本地 AI 的门票,正在变得越来越便宜。

选题来源:Hacker News(Show HN,2026-10-02)与项目 GitHub 仓库 README 交叉核实。

Comments

…
只用 8000 美元的训练成本,AI 把「战争棋」最后的人类堡垒也攻破了

AI 之眼俯视战争棋棋盘
AI 之眼俯视战争棋棋盘

如果说围棋的陷落是 AI 在「完全信息」世界里登顶,那么 Stratego(陆军棋/战争棋)的陷落,则是 AI 在「信息残缺」的真实世界里插上了旗。9 月 30 日,卡内基梅隆、MIT、纽约大学和斯坦福的研究团队在《自然》发表论文,宣布他们的 AI 系统 Ataraxos 以 15 胜 1 负 4 和的战绩,正面击败了历史上最成功的 Stratego 棋手、荷兰名将 Pim Niemeijer,并在当年世锦赛上对顶尖人类棋手打出 39 胜 2 负。更让人咋舌的是整个训练账单:16 张英伟达 H100 跑一周,大约 8000 美元。

为什么 Stratego 曾被认为「特别难」

Stratego 是个有着八十多年历史的经典策略游戏:双方各 40 枚棋子,军衔从高到低隐藏排布,对手看不见你的布阵,你也看不见他的。理论上的棋子排布组合超过 10 的 66 次方——这个数字大到德州扑克的 AI 技术根本没法直接套用。麻省理工的资深作者 Gabriele Farina 形容:「在这里,你要面对的『可能宇宙』会爆炸式增长。」

这不是人类第一次在 Stratego 上输给 AI。2022 年,DeepMind 的 DeepNash 已经达到职业水准。但 DeepNash 走的是「大力出奇迹」路线:数以百万计的训练对局,数百万美元级别的算力投入。而 Ataraxos 交出的成绩单是:在训练样本不到 DeepNash 百分之一、自博弈对局不到三十分之一的情况下,棋力反而更强,算力成本大约是后者的五百分之一。

决胜的关键:让 AI 在「出手前」先想清楚对手藏了什么

Ataraxos 的架构由三部分组成:自博弈强化学习训练出的策略-价值网络、一个预测对手隐藏棋子的「信念网络」,以及一套测试时搜索机制。

其中最关键的是信念网络。它是一个生成式模型,根据棋盘上所有可观测的信息,去推断对手棋子最可能的类型分布。团队首席作者、卡内基梅隆的 Samuel Sokota 解释说,Ataraxos 不是在瞎猜,而是用「决策时规划」锁定「最可信的棋盘状态」——先把对手可能的布阵收敛到一个可处理的范围,再在这个范围内做深度有限的推演。

这套机制顺带让 AI 学会了人类最擅长的东西:虚张声势,而且比人更懂分寸。Sokota 发现,Ataraxos 学会了动态调节诈唬的频率——「你诈唬得越多,对手就越提防,每次诈唬的价值就越低。」它甚至学会了情绪管理:Farina 说,「当人类最重要的棋子暴露时,人会开始慌,会过度补救反而暴露更多秘密;但这个机器人出奇地沉稳,它不慌乱,不乱补。」

AI 信念网络预测隐藏棋子
AI 信念网络预测隐藏棋子

同一套框架,横扫四个游戏

真正证明这不是「为一个游戏量身定制的雕虫小技」的,是团队的泛化实验:同一套方法稍作适配,就在另外三个不完全信息游戏里全部打出超人类水平——节奏更快的 Barrage Stratego(击败三位多次世界冠军)、需要多人协作的花火 Hanabi(2 到 5 人全部刷新最优纪录)、以及中国的斗地主(击败了此前的 PerfectDou 和 DouZero 两个知名机器人)。

这正是论文标题想表达的野心:《大规模隐藏信息下的超人类战略决策》。不完全信息博弈,恰恰是现实世界决策的常态:谈判桌上你不知道对方的底线,网络攻防中你不知道攻击者的下一步,供应链里你不知道上游的真实库存。棋盘只是最干净的试验场。

8000 美元背后,真正值得讨论的三件事

第一,AI 研究的「效率拐点」正在加速到来。从大模型的参数军备竞赛,到强化学习里「决策时规划」这类新范式的出现,「更聪明」正在部分替代「更大」。当然也要冷静:论文只公布了一个 headline 数字,没有拆分四个游戏各自的成本,也没计入调参过程中报废掉的试验次数——8000 美元是真实数字,但不是全部数字。

第二,「信念建模」可能是比下棋本身更重要的遗产。把「对手在想什么」显式建模成一个可学习的生成过程,这套思路完全可以迁移到智能体、自动驾驶的博弈预测、多智能体协作里。它是通往「在不确定世界里做决策」的通用设计模式。

第三,团队自己划出的红线值得注意:下一步工作是可解释性——让 AI 能用人能听懂的方式解释自己的决策。Farina 说:「人类必须对是否采纳建议有最终决定权,在能做到审计之前,谈落地还为时过早。」在一个 AI 替你做高风险决策的时代,这句话比 15:1 的比分更重要。

未来 AI 决策指挥中心
未来 AI 决策指挥中心

从深蓝到 AlphaGo,从德扑到星际,再到今天的 Stratego,棋类游戏作为 AI 里程碑的清单正在被逐一划掉。但这一次的意义不太一样:它划掉的不是又一个游戏,而是一种偏见——认为 AI 只擅长「信息透明」的确定性问题。Ataraxos 证明,面对藏起来的信息,AI 不仅能赢,还能赢得又便宜、又冷静。

而下一个战场,已经不在棋盘上了。

Comments

…

「AI 伴侣不能再装人类了」:康涅狄格州 AI 法案 10 月 1 日生效,开出全美第一张"机器人保姆"合规清单

美国东部时间 10 月 1 日,康涅狄格州参议院第 5 号法案(SB 5)——《人工智能责任与透明法案》(CART Act)的大部分条款正式生效。这是一部针对"AI 伴侣"聊天机器人的专门立法:从这一天起,在康州运营的 AI 聊天机器人公司,必须把"自杀风险检测""不得冒充人类""未成年人保护"写进产品合规清单,否则将面临州总检察长的执法行动。

背景:从两起悲剧到第一部专门法

过去两年,AI 伴侣类应用在全球爆发式增长的同时,也接连卷入悲剧。美国已出现多起未成年人因沉迷 AI 伴侣聊天机器人、产生情感依赖后自杀的诉讼,家属指控平台既未设置有效的危机干预机制,也未向用户明确披露"你在和 AI 谈恋爱"。这些案件把一个尖锐问题推到立法者面前:当聊天机器人被设计成"男朋友""心理医生"的样子时,法律该管谁、怎么管?

联邦层面迟迟没有统一立法,各州开始各自行动。此前加州、华盛顿、爱荷华等州已出台针对 AI 聊天机器人的零散规定,但康涅狄格州的 CART Act 是第一部把"AI 伴侣"作为独立法律概念、给出完整合规框架的州级法律。

事件:10 月 1 日生效了什么

这部法律由州长内德·拉蒙特于今年 5 月 27 日签署,采用分批生效设计:

10 月 1 日生效的条款:前沿 AI 开发者的"吹哨人保护"——大公司的员工可以匿名举报公司内部可能带来"灾难性风险"的 AI 研发活动;自动化就业决策技术的透明度规则;AI 生成内容的"出处标识"义务(音频、图像、视频必须附带难以篡改的来源数据);以及 AI 订阅服务的自动续费必须事先书面告知并获得用户同意。

其中"灾难性风险"被明确定义为:单次事件可能造成 50 人以上死亡或重伤,或超过 10 亿美元财产损失——比如用 AI 提供"专家级协助"制造生物武器、核武器,或在无人类实质监督下发动网络攻击。上一年总营收超过 5 亿美元的大型前沿开发者,必须在 2027 年 1 月 1 日前建好匿名举报通道。

2027 年 1 月 1 日生效的条款:真正针对 AI 伴侣的核心要求。法律把"AI 伴侣"定义为"具备自然语言界面、能给出适应性类人回应、并能跨多次交互维持关系的 AI 形态"。运营商必须做到:建立协议,检测用户是否"明显表现出自杀、自残或迫在眉睫的暴力风险",并内置预防措施、把用户转介到 988 自杀预防热线等心理健康资源;明确、持续地披露"你在和 AI 对话",对已知未成年用户每小时披露一次、成年用户每三小时一次;机器人永远不得声称或暗示自己是人类,哪怕用户直接追问。

对未成年人还有一整张"禁令清单":禁止提供可能诱发自残、自杀意念、饮食失调、暴力或药物滥用的伴侣;禁止浪漫或性互动;禁止"为取悦用户而牺牲事实准确性";禁止用奖励机制刻意延长使用时长。只有持证心理健康专业人士、且有充分同行评议临床试验证据支撑安全性的场景,才是例外。未成年人使用 AI 伴侣原则上需要家长控制手段。

分析:谁会被这部法律改变

首先是头部 AI 公司。吹哨人保护和匿名举报通道瞄准的是年营收 5 亿美元以上的"前沿开发者"——这几乎就是 OpenAI、Anthropic、谷歌这个量级的玩家。把"灾难性风险"的举报权交给一线员工,意味着实验室内部的安全争议第一次有了法定出口,这比任何外部审计都更接近真相。

其次是 Character.AI、Replika 这类 AI 伴侣产品。每小时一次的"非人类"披露、危机检测协议、未成年人禁令清单,每一条都是直接的工程成本:年龄识别要做准、内容审核要跟上、产品经理最爱的"延长停留时长"指标可能要和法律正面冲突。合规成本对大公司是毛毛雨,对初创团队可能是生死线——这部法律客观上抬高了 AI 伴侣赛道的准入门槛。

第三是"AI 生成内容必须带出处"的规定。康州要求 AI 生成的音视频附带难以剥离的来源标识,一旦多州跟进,"无标识 AI 内容"在美国的流通空间将被系统性压缩,深度伪造的治理第一次有了可执行的技术抓手。

执法层面,违规将被定性为"不正当或欺诈性贸易行为",由州总检察长执法;伴侣聊天机器人条款还赋予用户和家长在三年内提起诉讼、索赔实际损失和惩罚性赔偿的权利。牙齿是有的,就看咬不咬得下去。

展望:一部州法,半张美国 AI 监管拼图

CART Act 的真正意义不在康涅狄格一州,而在于它补上了美国 AI 监管拼图里最缺的那一块:专门针对"情感型 AI"的规则。联邦立法缺位的状态下,各州正在用自己的法案拼出一张事实上的全国标准——加州管算法歧视,科罗拉多管自动化决策,康州现在管 AI 伴侣和吹哨人。

可以预见的是,2027 年 1 月伴侣条款生效前,会有一波产品改造潮:年龄验证、危机干预话术、披露弹窗,都会成为 AI 伴侣产品的标配。而更大的悬念是执法强度——州总检察长办公室是否有足够的技术能力,去判断一家公司的"自杀风险检测协议"到底是真有用还是纸面合规。

对普通用户来说,这部法律传递的信号很直白:以后再有一个"AI 男友"深情地说"我是真人",那就是违法的。而对整个行业,这是一个分水岭——AI 伴侣的"拟人化"红利时代结束了,"安全合规"将成为新的竞争维度。

Comments

…

欧洲算力“军火商”开足马力:法国 Bull 超算工厂产能翻倍,押注欧洲 AI 主权

在全球 AI 算力竞赛里,欧洲终于决定不再只当买家。10 月 1 日,法国国有超算制造商 Bull 重新启用了扩建后的昂热(Angers)工厂,把超级计算机机架的月产能从 6 台直接翻到 12 台。这笔 8000 万欧元的扩建,瞄准的是同一个目标:让欧洲训练前沿 AI 模型时,不再伸手向别人要算力。

配图
配图

事件:订单多到造不过来,只能扩产

Bull 首席执行官 Emmanuel Le Roux 对路透社表示,公司今年收到的订单创下历史新高。在欧盟 EuroHPC(欧洲高性能计算联合体)发出的 18 个招标项目中,Bull 拿下了 15 个,把惠普企业(HPE)等竞争对手甩在身后。

订单簿的厚度直接写在了车间里。法国为原子能委员会(CEA)订购的超算 Alice Recoque——以法国计算机科学家 Alice Recoque 命名,共 94 个机架、价值 5.54 亿欧元,将从今年底开始分阶段交付;与此同时,芬兰 3.88 亿欧元的 LUMI-AI 系统(Bull 历史上最大的单笔合同)也在并行组装。Bull 高管坦言:扩建之前,这两笔大单根本没法同时开工。

工业客户也在排队。空客今年在图卢兹和汉堡启用了 Bull 建造的超算,这是一份为期五年、价值近 1 亿欧元的合同,让空客的仿真能力翻了三倍。云服务商 OVHcloud 和欧盟支持的 Domyn,则正在 Bull 打造的 JUPITER 超算上尝试训练前沿级 AI 模型——JUPITER 是欧洲第一台 E 级(百亿亿次)超算,坐落在德国于利希研究中心。

背景:四十年前的一课,欧洲记到了今天

Bull 的故事本身就是欧洲“算力主权”执念的缩影。今年 3 月 31 日,法国政府从负债累累的 Atos 手中买下 Bull,估值最高 4.04 亿欧元,动机毫不掩饰:战略自主。早在上世纪 80 年代,美国停止向法国原子能机构出口超级计算机,法国被迫转向 Bull 自研——那次断供,成了欧洲超算产业的“原点时刻”。

此后欧盟在 2021–2027 年间承诺投入 70 亿欧元,建设覆盖全欧的超算网络,目标就是弥合与美国在算力上的差距。而昂热工厂是全欧洲唯一专门制造这类机器的工厂,扩建后明年产能还可进一步提到每月 24 个机架。值得注意的是,Bull 机器中欧洲本土部件的占比,已从五年前的两三成提升到 70%;今年 6 月,Bull 还与富士康签约,在捷克生产英伟达 NVL 系统、最后在昂热总装——供应链正在向欧洲回拢。

分析:卖铲子的人,先把自己的铲子厂扩大了

配图
配图

这轮扩产最耐人寻味的地方在于时序:它不是“先建厂再找订单”,而是“订单爆了才被迫扩厂”。EuroHPC 18 中 15 的中标率说明,在欧洲公共算力采购这个市场上,Bull 几乎没有真正的对手。这既是优势,也是隐忧——单一供应商格局下,交付能力就是欧洲 AI 战略的天花板,扩产本质上是在给整个欧洲的“AI 工厂”计划拆瓶颈。

另一个信号是客户结构的变化:从 CEA 这样的国家实验室,到空客这样的工业巨头,再到 OVHcloud、Domyn 这样要训练前沿大模型的云厂商,超算正在从“科研奢侈品”变成“产业基础设施”。空客用超算把仿真能力翻三倍,意味着飞机的气动设计、材料验证越来越依赖算力而非物理试验——算力正在重塑传统制造业的研发流程。

展望:2027 年,欧洲算力版图可能彻底改写

配图
配图

按 Bull 的规划,昂热工厂 2027 年具备再次扩产的条件,月产能上探 24 个机架。如果订单增速不减,欧洲有望在 2027 年前建成一张“主权算力网”:E 级超算打底、AI 工厂承接产业需求、本土供应链占比继续爬升。

当然,挑战同样真实:芯片依然依赖英伟达、AMD、英特尔,70% 的本土部件占比里,最核心的加速器仍是“美国芯”。Bull 的扩产解决的是“组装能力”,而非“芯片能力”。欧洲真正的考验,是能不能在 2027 年之后,把这条从工厂到芯片的链条彻底打通。在那之前,昂热工厂的灯火通明,至少证明了一件事:欧洲已经不想再当算力竞赛的观众了。

Comments

…

用自家模型给 GPU 账单打八九折:微软 MAI 的降本实测

微软MAI降本题图
微软MAI降本题图

【背景】

AI 行业正在经历一场静默的转向:上半年大家还在比谁的模型更聪明、谁烧的 token 更多(圈内戏称"tokenmaxxing"),下半年画风突变——巨头们集体开始捂钱包。亚马逊、Uber、Meta、埃森哲相继传出削减 AI 开支的消息,而烧钱最多的微软,终于把刀挥向了自家最大的成本项:付给别人的模型费用。

微软的处境很典型。作为 OpenAI 最大的商业伙伴和 Anthropic 的大客户,它一边卖着 Copilot 订阅,一边按 token 给上游交"过路费"。订阅收入是固定的,token 账单却随着用户使用量水涨船高,毛利就这样被一点点吃掉。AI 业务负责人穆斯塔法·苏莱曼(Mustafa Suleyman)早就把话挑明:"我们付给 Anthropic 很多钱,目标是把这笔成本降下来,最终清零。"

【事件】

10 月 1 日,微软交出了一份"降本成绩单"。据 VentureBeat 报道,微软发布了新一代自研模型 MAI-Image-2.5 和 MAI-Voice-2-Flash,更重要的是附上了一组生产环境实测数据——这在巨头中相当罕见:

Bing Image Creator 已全线切换到 MAI-Image-2.5,这是微软第一次把一款面向消费者的图像工具完全交给自研模型;在 PowerPoint 里,同款模型相比 OpenAI 的 GPT-Image-2,GPU 成本最高下降 84%;OneDrive 把它设为默认图片编辑模型后,保存率提升 26%,P95 延迟下降约 25%。

语音侧的数据更夸张。MAI-Voice-2-Flash 驱动 Dynamics 365 联络中心(T-Mobile、易捷航空等客户在用),微软称 GPU 成本降幅最高达 89%。医疗场景的 Dragon Copilot——服务 17 万家医疗机构、上季度处理了 2800 万次问诊记录——换上 MAI-Transcribe-1.5 后,转写和语种识别错误率相对下降 50%,覆盖 58 种语言。

微软语音AI
微软语音AI

这与彭博社此前的爆料相互印证:微软已开始把 Excel、Word、Outlook 里的一部分用户请求路由到自家 MAI 模型,每周数以万计,不再经过 OpenAI 或 Anthropic。今年 6 月 Build 大会上,微软一口气发布了 7 个 MAI 模型,包括首个推理模型 MAI-Thinking-1,宣称代码能力对标 Anthropic 的 Claude Opus 4.6。

微软模型家族
微软模型家族

【分析】

这件事有三层含义,值得细品。

第一,AI 竞赛的 KPI 变了。过去比的是榜单分数,现在微软晒的是"GPU 成本降 89%""保存率提升 26%""错误率降一半"——全是经营指标。当 AI 从演示 Demo 变成每天被调用上亿次的基础设施,单位成本就是生死线。苏莱曼的团队只有 10 个人,却做出了"半价 GPU"的模型,说明"小而专"正在挑战"大而全"的规模迷信。

第二,微软在玩"模型家族化"。它没有押注一个超级旗舰模型通吃所有场景,而是按场景拆分:创意工作室要极致画质,客服中心要扛住每天几百万通电话,医疗要零容忍的转写精度。不同场景配不同模型,各自优化到极致。这种思路其实更贴近工程现实——杀鸡不需要牛刀,牛刀还贵。

第三,这是对上游的"温柔施压",不是分手。微软一边自研,一边仍是 OpenAI 最重要的云和商业伙伴。把一部分流量切到自家模型,省下的不只是钱,更是谈判桌上的筹码。当你有能力说"不用你我也行",下一轮合作的条款自然不一样。Anthropic 和 OpenAI 的销售团队,这个季度恐怕不太好过。

【展望】

微软的路线图已经写明:2027 年要拿出"前沿级"大模型,彻底摆脱对外部模型的依赖。如果 MAI 真能持续兑现"便宜又好用",整个行业的定价体系都会被重写——当最大的买家开始自己种粮食,卖种子的生意就没那么好做了。

更大的图景是,AI 行业正在从"军备竞赛"进入"买单周期"。训练侧还在烧钱盖数据中心,推理侧已经开始精打细算。中国厂商的便宜模型被一些硅谷公司悄悄拿来做智能体降本,尽管伴随着安全顾虑——成本压力面前,务实主义压倒了意识形态。

对普通用户来说,这是个好消息:AI 功能的成本降下来,免费额度才会多起来,订阅价格才有下降空间。下一次当你用 PowerPoint 一键生成配图、用 OneDrive 修图时,背后跑的可能已经不是 GPT,而是一个更便宜、更快、专为这个场景调教的"自家孩子"。而这,或许才是 AI 真正走向普及的开始。

(全文结束)

Comments

…

从"代工老二"到算力新贵:和硕 AI 服务器的十倍速狂奔

题图
题图

背景:AI 服务器的"后进者"逆袭剧本

提起台湾的电子代工巨头,人们首先想到的是鸿海(富士康)和广达——前者是全球最大电子制造服务商,后者是 AI 服务器出货量最大的代工厂。和硕(Pegatron)则长期被视为"老二":它是 iPhone 的重要组装商,但在中国大陆以外的 AI 算力盛宴中,起步明显晚了一步。

然而 AI 服务器的牌桌正在重新洗牌。英伟达 Blackwell 架构的 GB200、GB300 整机柜系统组装难度极高,液冷、供电、高速互联每一环都是硬骨头——这意味着"会组装手机"不等于"会组装 AI 服务器",但也意味着只要啃下这块硬骨头,后进者同样能分到一杯羹。和硕过去两年一直在默默练功:从主板级代工转向整机柜系统集成(L10/L11 等级),墨西哥新厂试产、德州厂在建,团队一路扩充。

事件:9 月出货,"十倍增长"进入收获期

10 月 1 日,和硕共同执行长郑光志对外释放了一连串重磅信号:

第一,美系客户的新订单已经开始出货,将直接反映在 9 月业绩中。市场甚至传出,和硕拿下了美国一家电动汽车大厂的 AI 服务器订单(公司未正面证实,但承认"今年 AI 服务器业务进展不错")。

第二,今年 AI 服务器营收比重有机会挑战一成。要知道,和硕此前在法说会上曾表示,服务器业务年增十倍的目标"非常有把握达成",一到两年内服务器有望跻身公司前三大事业部门。从几乎为零到一成营收占比,这是典型的指数级爬坡。

第三,GB200 与 GB300 双线出货,且 GB300 的量已经超过 GB200。郑光志的解释很实在:GB200 初期设计复杂、组装难度高,市场过渡期较短;GB300 成熟度更高,300 个机柜从组装角度看相对顺畅。不过由于总体拥有成本(TCO)考量,仍有部分客户选择性价比更高的 GB200——两代产品并存,反而让和硕的产线利用率更饱满。

第四,AI 服务器团队已突破 1000 人,还要继续扩。在代工行业,"人"就是产能的先行指标。

值得注意的是,郑光志还透露了一个行业风向标式的判断:过去业界最焦虑的是"电力够不够",现在焦点变成了"资金够不够"——"台湾的钱已经不够用了",需要到海外借贷来支撑全球运营。这句话背后,是整个 AI 基建链条从"技术瓶颈"转向"资本瓶颈"的缩影。

在全球布局上,和硕采取"美国厂+墨西哥厂"综合评估策略,"看客人的需求与布局,我们大概都是 ready 的"。目前美国厂占整体营收比重不到 5%,但德州新厂预计明年 3 月底完工、随即试产,墨西哥厂则聚焦 AI 服务器量产——显然是在为下一轮订单潮铺路。

分析:为什么是和硕?三个被低估的变量

分析配图
分析配图

变量一:客户结构反而更分散。 分析师指出,和硕 AI 服务器的客户集中度低于同业,横跨多家云服务商与企业客户,订单能见度看到 2027 年。在"大客户依赖症"普遍的代工行业,分散意味着抗风险能力——当某一家超大规模云厂商砍单时,和硕受到的冲击更小。

变量二:L11 整机柜是毛利率跳板。 从主板代工升级到整机柜系统集成(L11),单价和毛利率同步提升。这是和硕敢喊"挑战一成营收占比"的底气:卖的不再是廉价组装工时,而是包含液冷、供电、系统集成的整柜方案。

变量三:推理服务器 + ASIC 是第二曲线。 除英伟达 GPU 机型外,和硕还在切入推理服务器和 ASIC(专用芯片)系统——有些客户自己设计 AI 芯片、只缺系统集成商。和硕的角色从"代工厂"变成"系统方案商",这正是广达、纬颖当年走过的路。

当然风险同样真实:GB200 组装良率爬坡的阵痛、液冷供应链的紧缺、以及"十倍增长"目标本身的高基数压力。但至少从 9 月出货这个节点看,和硕已经拿到了牌桌上的筹码。

展望:代工版图的"第三极"正在成型

展望配图
展望配图

AI 服务器的代工格局,过去是"鸿海+广达"双雄争霸,纬创、英业达紧随其后。和硕的异军突起,意味着"第三极"正在成型——而这对整个产业链都是好事:英伟达需要更多元的供应链来分散地缘与产能风险,云厂商需要更多供应商来压价,台湾则需要更多"不把鸡蛋放在一个篮子里"的代工厂。

郑光志那句"台湾的钱已经不够用了",听起来是抱怨,实则是宣言:AI 基建的军备竞赛,已经从"谁的技术强"打到了"谁的资本厚、谁的全球布局快"。和硕选择用海外借贷+美墨双厂来应战,这场仗才刚刚开打。

对观察者而言,接下来的看点很清晰:9 月营收数字是否如期兑现、GB300 的出货爬坡斜率、以及德州厂明年投产后美国本土产能占比能否突破 5%。如果这三个问号都变成惊叹号,和硕的"十倍速狂奔"就不再是口号,而会是 2026 年代工行业最值得复盘的案例之一。

(全文完)

Comments

…

23 个月!全球首座增强型地热电厂并网发电,地热的「奇点时刻」到了?

钻井平台夜景
钻井平台夜景

当所有人都在为 AI 数据中心到处“找电”时,有人把目光投向了地下几千米的炽热岩石。10 月 1 日,地热公司 Fervo Energy 宣布,其位于美国犹他州的 Cape Station 电厂已于 9 月 30 日正式开始向电网售电——比原计划提前了一天。这不是普通的电厂投产:它是全球第一座实现商业运营的增强型地热(EGS)电厂,从破土动工到并网发电只用了 23 个月。

事件:提前一天,创造历史

Fervo 在周四上午的声明中透露,Cape Station 的首批机组约在一周前完成与电网的同步,9 月 30 日起正式售电。这批机组约占项目一期规划 100 兆瓦的三分之一,而整个站址的远期潜力可达 4 吉瓦——相当于几座大型核电机组的规模。

“世界上没有任何团队建成过这样的项目,而我们还提前了。”Fervo 联合创始人兼 CEO 蒂姆·拉蒂默(Tim Latimer)在声明中说。

更值得注意的是速度:首期区块从打下第一根桩到商业运营只花了 23 个月,Fervo 称后续区块有望压缩到 18 个月。对比一下——一座核电站从开工到发电往往需要十年以上。23 个月,在电力基建领域是个相当激进的数字。

买家名单同样亮眼:谷歌、南加州爱迪生电力公司等都已签署购电协议;据《华尔街日报》报道,算上壳牌等客户,Fervo 手握的购电合同总量已接近 1000 兆瓦。

背景:增强型地热,到底“增强”了什么?

传统地热发电有个天然限制:只能在火山、间歇泉等浅层热源丰富的地方建厂,全球适合的地点屈指可数。增强型地热要打破这个限制——往深处打。地壳越深温度越高,如果能钻到几千米深的干热岩层,理论上哪里都能建地热电厂。问题是干热岩渗透性极差,水流不进去、热量出不来。

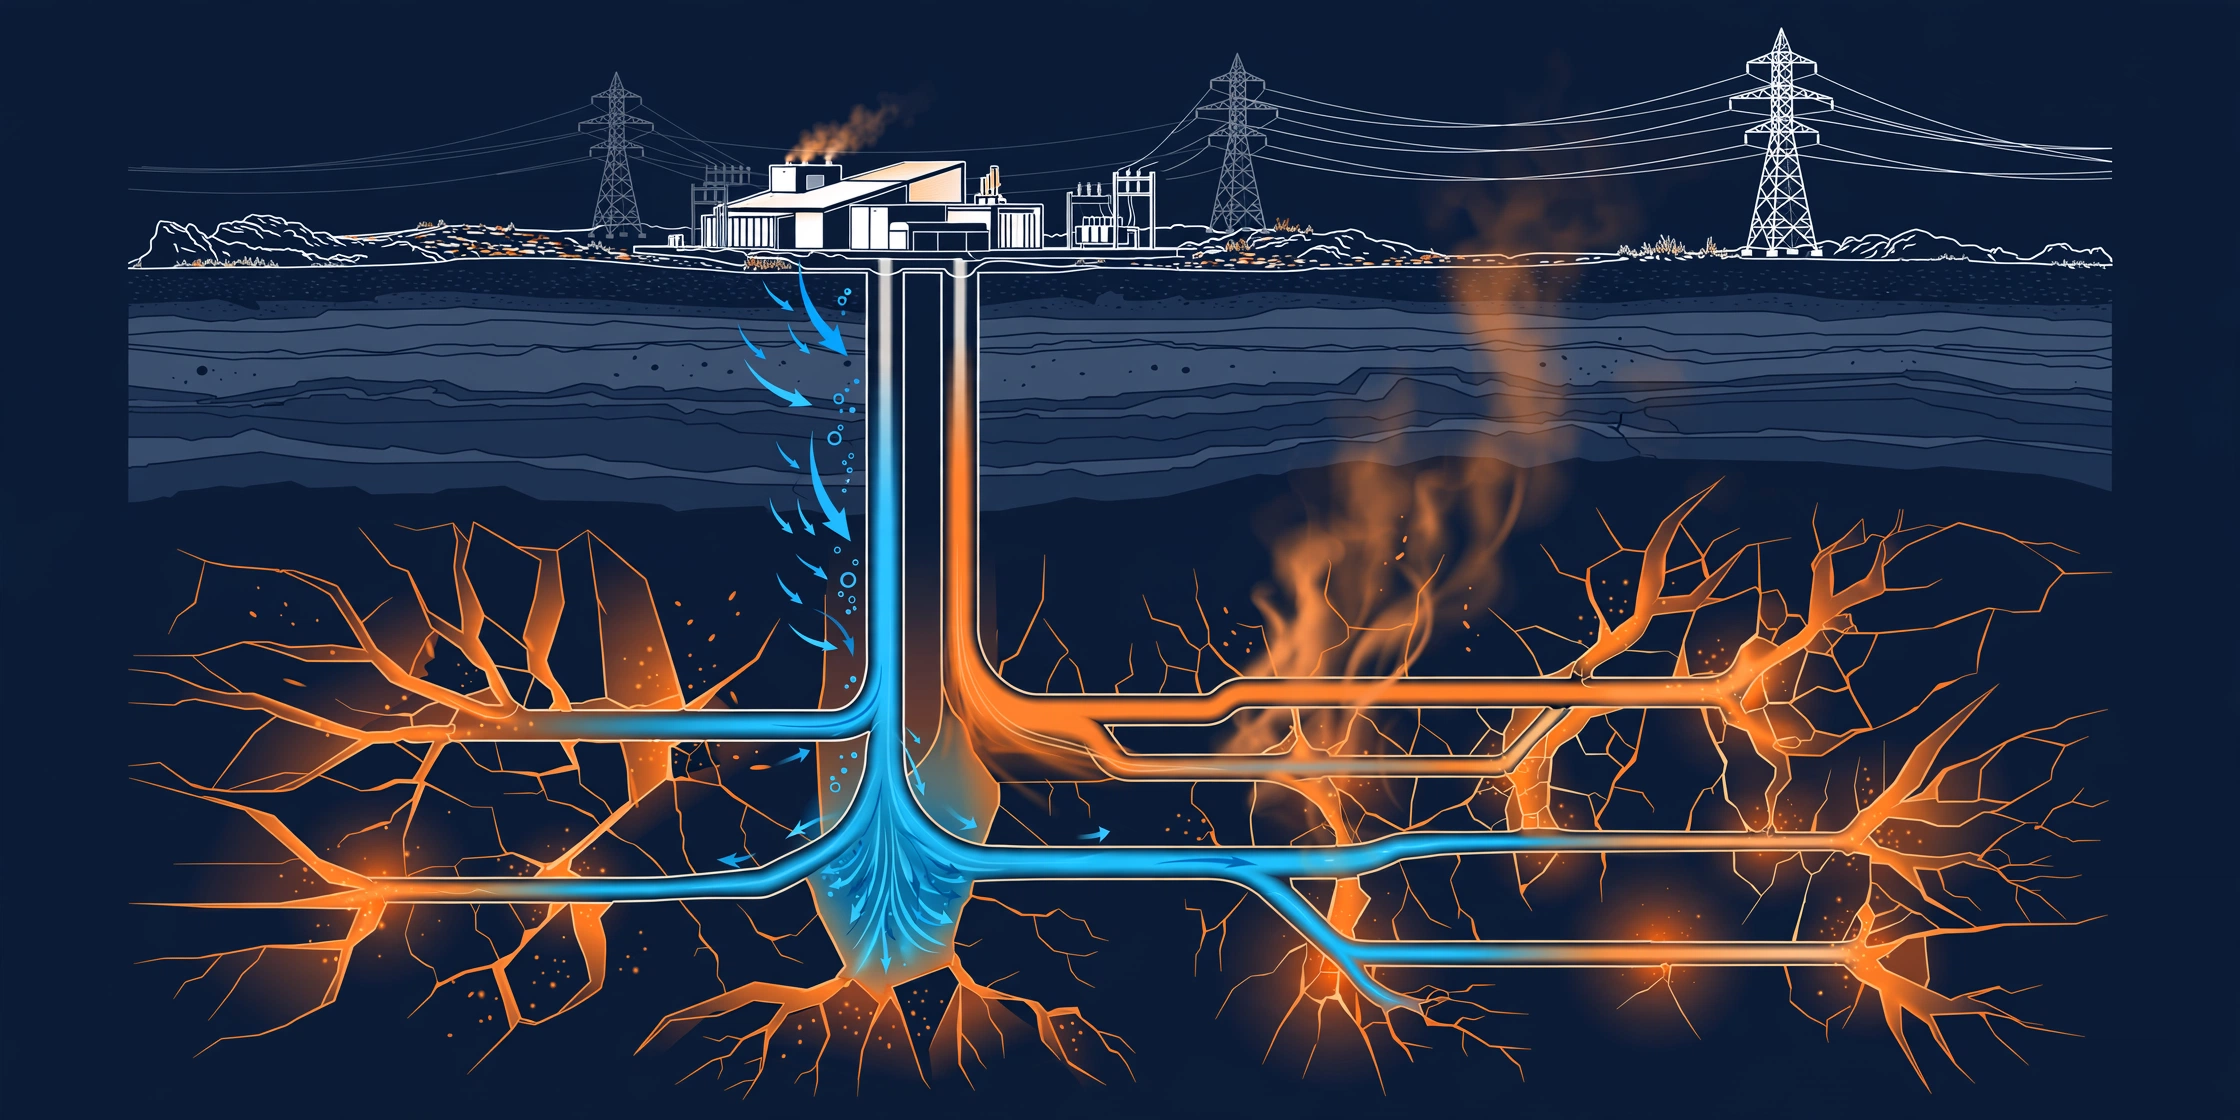
增强型地热剖面示意图
增强型地热剖面示意图

Fervo 的解法是从石油天然气行业“借”技术:水平钻井 + 水力压裂,在深部岩层中人工制造裂缝网络,再注入冷水、回收蒸汽发电,同时用光纤传感实时监测地下裂缝形态。等于把页岩气革命的那套工程方法论,完整复制到了地热领域。这家公司由前油气工程师拉蒂默创立,背后站着比尔·盖茨的 Breakthrough Energy Ventures。

分析:为什么这一次值得认真看待?

第一,这是 EGS 第一次真正“交卷”。 全球做增强型地热的不止 Fervo 一家,但此前所有项目都停留在试点示范阶段。并网售电意味着它通过了最严苛的检验:电网调度、连续运行、商业结算。意义不在于这 30 多兆瓦,而在于证明了路径可行。

第二,速度即正义,恰好卡中 AI 的用电焦虑。 数据中心运营商正在全美“扫货”式找电:天然气轮机排期要等几年,核电重启动辄十年,风光虽快但出力不稳定。地热恰好是 24 小时不间断的基荷电源,还能分期建设——电厂一区块一区块地上,数据中心一栋一栋地建,节奏天然契合。

第三,成本曲线的想象空间。 EGS 最大的质疑一直是成本。但 Fervo 押注“学习曲线”——油气行业用二十年把水平井成本打下来了,地热钻井走同样的路。23 个月建成首期、目标 18 个月,就是学习曲线起作用的证据。

当然挑战同样真实:深部钻探依然昂贵且有地质不确定性,压裂诱发微震需要持续监测,电网配套也不是一蹴而就。Fervo 能否兑现 18 个月的目标、真正把成本打下来,还需后续区块验证。

数据中心与地热电厂
数据中心与地热电厂

展望:AI 时代的“基荷电源新贵”?

Cape Station 的并网可能标志着一个转折:清洁能源的竞争,正从“谁更便宜”转向“谁更可靠”。风光解决了便宜的问题,但 AI 数据中心要的是 7×24 小时不停机的确定性——这正是地热这类基荷电源的舞台。如果 Fervo 能把 4 吉瓦的潜力逐步兑现,增强型地热很可能成为继页岩气之后,又一个“借来的技术”改写能源版图的案例。地热行业等了几十年的“奇点时刻”,也许真的近了。

消息来源:TechCrunch(2026-10-01)、《华尔街日报》、Fervo Energy 官方声明;多方交叉核对。

Comments

…

三天吃下 33% 份额:iPhone 18 Pro 中国首销反超,国产旗舰涨价反而成全了苹果

iPhone 18 Pro 发布会舞台题图

三天,33%。苹果用一组看起来不讲道理的数据,给中国智能手机市场的「涨价季」画了个句号。

市场调查机构 Counterpoint Research 9 月 30 日发布的《中国智能手机周度销量追踪报告》显示,iPhone 18 Pro 系列在中国市场上市头三天,销量比 iPhone 17 Pro 系列同期增长 12%。更夸张的是开卖节奏:iPhone 18 Pro 系列 9 月 18 日才开售,2026 年第 38 周(9 月 14 日至 20 日)里它只贡献了三天销量,苹果却靠这三天直接登上中国智能手机周销量榜首,市场份额达到 33%。

这不是一场靠降价换来的胜利。恰恰相反,这是一场在全行业涨价潮里打赢的硬仗。

一台更贵的 iPhone,遇上一个更贵市场

国行 iPhone 18 Pro 的定价并不「友好」:256GB 和 512GB 版本比上代涨了 1000 元,1TB 和 2TB 分别涨了 2500 元和 3500 元。但把镜头拉远会发现,2026 年的中国高端手机市场没有便宜货——受存储芯片成本暴涨影响,国产旗舰今年普遍涨价超过 200 美元,大容量存储版本和 2nm 芯片机型的涨幅尤其离谱。

原本国产旗舰靠性价比卡住 4000 到 6000 元价位段,和 iPhone 之间保持着一道微妙的价格墙。涨价潮把这道墙推平了:当国产旗舰卖到七八千,消费者掏出计算器一算——都花到这个数了,为什么不直接上 iPhone Pro?Counterpoint 高级分析师 Ivan Lam 的判断很直白:中国品牌旗舰涨价抬高了消费者对旗舰机的价格锚点,缩小了与 iPhone 的价格差距,反而凸显了 iPhone Pro 系列的相对价格优势。

更微妙的是苹果自己的价格手术。256GB 和 512GB 只涨 1000 元,而顶配涨幅翻倍——用高容量版本的利润摊薄主流版本的成本,让大多数买家面对的涨幅「可以接受」。数据显示,预购阶段约六成订单选了更小的 iPhone 18 Pro,开售后 Pro Max 反倒占到 55.5%,高端机型卖得比标准版还猛。这种「越贵越好卖」的结构,在安卓阵营几乎看不到。

被延迟的基础版,意外成了神助攻

这场首销爆发还有一个隐藏变量:iPhone 18 基础版延迟上市。想换新机的用户没有退路,需求被整体挤向 Pro 系列。渠道支持和早期换机需求叠加,让 Pro 系列吃到了本该属于全系的红利。

当然,胜利者也有槽点。第三方测试发现,1TB 与 2TB 的 iPhone 18 Pro Max 采用了 SK 海力士 QLC 闪存,缓存用尽后持续写入速度平均仅 79.4MB/s,比 512GB 的 TLC 机型慢约 38%;三星 G9N 屏幕的偏轴色偏也差于上代。这些细节在销量面前没有掀起水花,但说明一个现实:在供应链成本压力下,连苹果也在高端机型上做起了「隐性降配」。

iPhone 18 Pro 销量图表
iPhone 18 Pro 销量图表

分析:6000 元以上,是苹果一个人的战场

调研数据显示,iPhone 在 6000 元以上价位段的份额超过 60%。这个区间的用户对价格相对不敏感,认的是品牌。国产旗舰涨到 7000 块,用户扭头就走——品牌心智的壁垒在涨价潮里反而被加固了。

更值得玩味的是市场大盘:自 7 月以来,中国智能手机周销量持续同比双位数下滑,存储成本上涨让消费者需求持续疲软。也就是说,iPhone 18 Pro 的爆发不是在增量市场里抢蛋糕,而是在萎缩的市场里重新切分存量。能做到这一点的厂商,靠的不是参数,而是定价权和供应链议价权——苹果能把涨幅精确控制在「主流版本只涨 1000」,本身就是供应链实力的体现。

华为近期推出的阔直板手机 Pura X View 采用 16:9.5 宽屏比例,把折叠屏的宽屏体验塞进无铰链直板机,首销同样强劲。但华为的强势集中在折叠屏和差异化形态上,在传统直板旗舰赛道,苹果依然没有对手。

芯片战场
芯片战场

展望:标准版和 Air 还没上场

这场 33% 的登顶,可能只是上半场。iPhone 18 标准版与 iPhone Air 尚未发布,等到全系到齐,苹果的市场份额还有上冲空间。国产阵营的压力则在另一头:9 月新款旗舰多数赶在国庆假期前开售,存储成本上涨导致的涨价已经传导到终端,预计将对后续销售形成持续压力。

一个更长期的信号是,存储涨价潮正在重塑整个行业的竞争逻辑。当「内存荒」从供应链传导到定价,谁能把成本涨幅消化在供应链内部,谁就能在终端定价上保持主动。这场较量里,苹果用三天 33% 证明了一件事:涨价本身不是问题,问题是涨价之后,你还值不值那个价。

Comments

…

内存"砍半"也要造:马斯克亲口承认,特斯拉 AI5 芯片内存直接腰斩

背景:一颗"生死攸关"的芯片

今年年初,马斯克用"生死攸关"来形容特斯拉 AI5 芯片的研发难度。他甚至透露,为了把 AI5 做出来,自己连续几个月每个周六都在亲自跟进芯片团队。

AI5 是特斯拉下一代自研 AI 芯片,肩负着两副重担:一是支撑新一代完全自动驾驶(FSD)的车载计算,二是成为人形机器人 Optimus 的"大脑"。今年 3 月底,这颗芯片顺利完成流片,马斯克还晒出了芯片实拍图:中央是一颗巨大的主计算 die,周围环绕着 12 颗 DRAM 内存颗粒,布局相当有气势。

按照原规划,AI5 堪称特斯拉有史以来最激进的一代自研芯片:半掩膜尺寸、台积电与三星双源代工、2nm 工艺、2000-2500 TOPS 的 AI 算力,单芯片对标英伟达 H100,双芯片版本则对标 Blackwell。内存方面,原计划搭载 144GB 的 LPDDR5。三星位于美国德州 Taylor 的工厂已经启动试产,目标 2027 年实现量产。

事件:内存砍半,只为"有货"

10 月 1 日,马斯克在 X 上亲口公布了一个出人意料的决定:

"我们把特斯拉 AI5 芯片的内存砍了一半(现在是 72GB 的 LP5),AI6 的内存砍了三分之一(现在是 144GB 的 LP6)。这是唯一能拿到足够 Optimus 量产规模供货、并大幅降低成本的办法。"

AI5 的内存从 144GB 直接腰斩到 72GB LPDDR5;下一代的 AI6 则从原计划的约 216GB 降到了 144GB LPDDR6。

有意思的是,做出这个决定的背景是一个关于"机器人内存需求"的讨论:有人估算未来每台人形机器人可能需要约 200GB 内存,而全球 DRAM 一年的总产量约为 450 亿 GB。如果 Optimus 真的按马斯克描绘的宏大愿景铺开,内存供应会成为一个肉眼可见的瓶颈。特斯拉选择先下手为强——在芯片量产前就主动"降配",把有限的 DRAM 摊到更多台机器人上。

分析:带宽才是瓶颈,容量只是数字?

降配听起来像妥协,但马斯克的逻辑值得细品。他补充道,这次调整对 Optimus 的性能"影响可以忽略不计",因为"内存带宽才是更大的限制因素,而不是内存总容量——带宽我们保持不变"。

这个说法在工程上是成立的。对于机器人端侧推理,真正卡脖子的往往是"数据能不能以足够快的速度喂给计算单元",也就是带宽;而"能不能一次性装下超大模型",也就是容量,反而可以通过模型量化、权重分片等手段绕开。特斯拉坚持用 LPDDR 低功耗内存而非数据中心芯片常用的 HBM 高带宽内存,本就是一次成本与功耗的权衡——这次降配,是把同一逻辑推到更极致。

更深一层看,这是典型的"为量产而设计"。马斯克此前透露,AI5 和 AI6 的约一半 TRIP AI 计算加速器都配了 SRAM,其等效内存带宽是 DRAM 带宽的"一个数量级"。SRAM 撑带宽、DRAM 管容量、LPDDR 控成本——三层内存体系让砍容量不至于伤筋动骨。

再看 Optimus 的量产节奏:据 The Information 报道,特斯拉 Optimus 的周产量已从二季度的几十台提升到数百台,管理层的目标是年底前实现周产 1000 台、最终达到周产 2 万台。降配决策几乎就是为这个爬坡曲线量身定做的:内存减半,意味着同样的 DRAM 采购量可以造出两倍的芯片,直接解决"有货"问题,还顺手把单机成本打下来。

展望:2027 量产,DRAM 行业要重新算账

接下来看两个时间点:AI5 目标 2027 年量产,AI6 紧随其后。如果降配版 AI5 能如期交付,特斯拉将证明一条新路——端侧 AI 芯片不一定要堆容量,"够用就好"反而能换来产能和成本优势。

对存储行业而言,这是个需要重新算账的信号:一边是内存供应趋紧的预期,另一边是最大的潜在买家之一主动降低单机内存需求。DRAM 厂商的扩产计划,恐怕要开始把"机器人降配"这个变量算进去了。

对人形机器人和端侧芯片厂商,这也是一堂公开课:当产品从演示走向百万台量产,芯片设计的 KPI 会从"参数好看"变成"造得出来、造得起"。马斯克这刀砍在内存上,下一个被"优化"的会是什么,值得所有人盯着看。

Comments

…

把"垃圾抽屉"清理干净:SvelteKit 3 正式发布,Next.js 迎来最难缠的对手

题图
题图

【背景】编译时框架的"另类"生存之道

2016 年,Rich Harris 为新闻网站做互动图表时受够了 React 的臃肿,给出了一个离经叛道的答案:Svelte。它的核心理念至今没变——别人家框架把活儿留给浏览器在运行时干,Svelte 则在编译时就把组件"熬成"精简的原生 JavaScript,浏览器拿到的是一份成品,而不是一个沉重的通用执行环境。

围绕 Svelte 长出的应用框架 SvelteKit,则负责补齐路由、服务端渲染、数据加载这些"造整站"的能力,目标直指 Next.js 的地盘:一个更简单、更少折腾的全栈 Web 框架。这几年它稳步增长,核心维护者甚至被 Vercel(Next.js 的东家)招致麾下——一个颇具戏剧性的注脚:对手也在押注这条技术路线。

【事件】3.0 正式版落地:减法为主,迁移体验拉满

迁移插图
迁移插图

10 月 1 日前后,Svelte 团队在官方博客宣布 SvelteKit 3.0 正式版发布。自 8 月 13 日进入 RC(候选发布)阶段以来,团队承诺不再引入破坏性变更,3.0 如约转正。这次大版本更新的画风很特别:主打的不是"加了多少新功能",而是"清理了多少旧包袱"——官方博客的原话是"清理垃圾抽屉"(cleaned out the junk drawer)。

几个关键变化:

  • 配置搬家:框架配置从 svelte.config.js 迁入 vite.config.ts,与 Vite 8 工具链彻底对齐,不再维护两套配置体系;
  • 别名换血:用了多年的 $lib 别名改为 #lib,拥抱 Node.js 标准的子路径导入(subpath imports),少造一个轮子;
  • 环境变量更好用:能力更强、写法更直观;
  • Service Worker 瘦身:样板代码大幅减少;
  • 错误处理全线改进。

最值得说的是迁移体验。官方提供一键迁移命令:

text
npx sv migrate sveltekit-3 --tasks all --confirm

它会自动迁移尽可能多的代码,迁不掉的部分生成一份 TODO 清单。官方博客甚至调侃:"如果你习惯让 AI 结对编程,你的机器人朋友三两下就能搞定。"把大版本迁移从"灾难片"拍成"流水线作业",这本身就是一种产品力。

【分析】3.0 真正的赌注,藏在"还没发布"的功能里

有意思的是,3.0 发布公告里最抓眼球的一段,讲的是一个还没准备好的功能:Remote Functions(远程函数)。官方直言这是"当前最高优先级"。

Remote Functions 想解决什么问题?今天你在前端组件里调服务端逻辑,要么写 API 路由,要么用框架特制的 load 函数/action,样板代码一堆。Remote Functions 的野心是:让你像调用普通函数一样直接调用服务端逻辑,全程类型安全,框架在背后处理通信细节。Next.js 的 Server Actions 玩的是类似的概念,但 Svelte 团队认为自己的方案会更顺手。

这个功能需要 Async Svelte 的支持,目前还得开实验性标志才能用。换句话说,SvelteKit 3.0 的本质是一次"铺路":清理旧 API、向平台标准靠拢、把地基打牢,真正的杀手锏(Remote Functions + Async Svelte)还在路上。团队选择先发布一个干净的 3.0,而不是把半成品塞进大版本,这种克制值得尊敬。

另一个观察:Svelte 团队已明确表态不会跟进 React Server Components,认为 RSC 是 React 特有的模型。这不是保守,而是一种清醒——当所有人都在抄 React 的作业时,Svelte 赌的是另一条路:编译时优化 + 更自然的客户端-服务端通信。如果 Remote Functions 落地后体验真的"让其他方案看起来笨拙"(官方原话),Next.js 的护城河会被挖掉一块。

【展望】下一场战争:谁重新定义"前后端通信"

展望插图
展望插图

短期看,3.0 对存量项目是好消息:迁移成本被压到很低,升级几乎没有理由拖延。对想入坑的新项目,sv create 一把梭即可。

中长期看,真正的看点是 Remote Functions 何时转正。一旦它随 Async Svelte 稳定下来,SvelteKit 将拥有全栈框架里最优雅的客户端-服务端调用体验——这可能是它从"小而美"走向"主流选项"的关键一跃。11 月 19-20 日的 Svelte Summit(卢布尔雅那)大概率会放出更多消息,值得盯。

前端框架的战争从来不缺新版本,但缺"想清楚自己要去哪"的新版本。SvelteKit 3.0 属于后者:它先把屋子收拾干净,然后指着远方说——真正的仗,在那儿打。

Comments

…